telnet 的退出 分成两种,一中是在telnet命令中,直接输入 quit 或者 q 即可退出。 二种情况是 已经进入了端口中,需要先从端口中退出,然后再退出telnet。
telnet 直接退出
输入 q 或者 quit 即可退出。
telnet 退出端口后退出telnet
- 输出
ctrl + ] q或者quit
telnet 的退出 分成两种,一中是在telnet命令中,直接输入 quit 或者 q 即可退出。 二种情况是 已经进入了端口中,需要先从端口中退出,然后再退出telnet。
输入 q 或者 quit 即可退出。
ctrl + ]q 或者 quit今天在看 kubectl-debug 这个项目的时候,看到其部署文件的 volumeMounuts 中使用了一个 mountPropagation 字段,因为不清楚这个字段的作用,就做了一下了解。mount propagation 背后的东西还是很多的,因此整理了这篇文章,顺便梳理一下知识点。
kubernetes 的 mount propagation 翻译成中文就是挂载传播。挂载传播提供了共享卷挂载的能力,它允许在同一个 Pod,甚至同一个节点内,在多个容器之间共享卷的挂载。
卷的挂载传播由 Container.volumeMounts 的 mountPropagation 字段控制。它的值有:
None: 这种卷挂载将不会收到任何后续由 host 创建的在这个卷上或其子目录上的挂载。同样的,由容器创建的挂载在 host 上也是不可见的。这是默认的模式。这个其实很好理解,就是容器内和 host 的后续挂载完全隔离。HostToContainer: 这种卷挂载将会收到之后所有的由 host 创建在该卷上或其子目录上的挂载。换句话说,如果 host 在卷挂载内挂载的任何内容,在容器中都是可见的。同样,如果任何具有 Bidirectional 的 Pod 挂载传播到该卷挂载上,具有 HostToContainer 的挂载传播都可以看见。整个挂载传播的流程如下:
Bidirectional: 这种挂载机制和 HostToContainer 类似。此外,任何在容器中创建的挂载都会传播到 host,然后传播到使用相同卷的所有 Pod 的所有容器。注意:Bidirectional 挂载传播是很危险的。可能会危害到 host 的操作系统。因此只有特权容器在允许使用它。在了解了这几种挂载传播之后,我们可以做一些实验来验证一下,首先验证的是 None 的挂载传播类型,我们创建一个 nginx 的Pod:
apiVersion: v1
kind: Pod
metadata:
    name: mount-a
    namespace: default
    label:
      app: mount
spec:
    containers:
    - name: main
      image: nginx:latest
      volumeMounts:
      - name: testmount
        mountPath: /home
        mountPropagation: None
    volumes:
    - name: testmount
      hostPath:
        path: /mnt/
YAML
然后我们分别向 host 的 /mnt 和容器的 /home 下挂载目录并查看容器和 host 的情况:
容器中:
$ kubectl exec -it mount-a sh
$ cd /home
$ ls
sda1
Bash
host 上:
$ cd /mnt
$ ls
sda1
Bash
然后在 host 上创建挂载:
$ mkdir /mnt/none
$ sudo mount --bind /var /mnt/none
$ ls none
cache  empty  lib  lock  log  run  spool  tmp
Bash
这个时候,我们再看容器中的文件:
$ ls none
# 无输出
Bash
这说明 host 上在该卷下的挂载并不会改变容器中的文件。接下来我们可以在容器中按照上面的方案来验证容器中的挂载也不会影响 host 中的目录视图。这里就不展示了。接下来看一下 HostToContainer 的挂载传播,我们将上面的 Pod 的 mountPropagation 字段改成 HostToContainer,然后先取消 host 上的挂载:
sudo umoint /mnt/none然后重新创建 Pod,和上面一样,在 host 上创建挂载,查看容器中的挂载情况:
$ ls none
cache  empty  lib  lock  log  run  spool  tmp
Bash
host 上的挂载因为 HostToContainer 机制传播到了容器中。我们继续看最后一种 Bidirectional 机制。这次我们要创建两个 Pod: mount-a, mount-b,并把 mountPropagation 字段改成 Bidirectional。注意,因为 Bidirectional 是危险的,所以只有特权容器才可以使用。因此这里还需要把容器改成特权模式,最后在 mount-a 中的容器执行挂载,验证挂载是否传播到 host 和 mount-b 的容器中。
apiVersion: v1
kind: Pod
metadata:
    name: mount-a
    namespace: default
    labels:
      app: mount
spec:
    containers:
    - name: main
      image: nginx:latest
      securityContext:
        privileged: true
      volumeMounts:
      - name: testmount
        mountPath: /home
        mountPropagation: Bidirectional
    volumes:
    - name: testmount
      hostPath:
        path: /mnt/
---
apiVersion: v1
kind: Pod
metadata:
    name: mount-b
    namespace: default
    labels:
      app: mount
spec:
    containers:
    - name: main
      image: nginx:latest
      securityContext:
        privileged: true
      volumeMounts:
      - name: testmount
        mountPath: /home
        mountPropagation: Bidirectional
    volumes:
    - name: testmount
      hostPath:
        path: /mnt/
YAML
然后进入 mount-a,创建挂载:
$ kubectl exec -it mount-a sh
$ su
$ mount --bind /var /home/none
$ ls /home/none
backups  lib    lock  mail  run    tmp
cache    local  log   opt   spool
Bash
这时候查看 host 下的 /mnt/none:
$ ls /mnt/none
backups  lib    lock  mail  run    tmp
cache    local  log   opt   spool
Bash
可以发现,容器中的挂载传播到了 host 上。这时候再查看 mount-b 中的容器。
$ ls /home/none
backups  lib    lock  mail  run    tmp
cache    local  log   opt   spool
Bash
挂载也传播到了 mount-b 的容器中。
上面分析了 kubernetes 的挂载传播机制,在 linux mount 中,也有类似的概念。mount 分为下面几种:
Bidirectional 的挂载传播HostToContainer, host 是 master,container 是 slave。None,挂载不会向任何一方传播。--bind 的挂载。kubernetes 的挂载传播不是其本身实现的,也不是 docker 之类的容器运行时提供的。这是由容器化技术的基础:linux namespace 提供的,linux namespace 当前共有 6 种:
其中,mount namespace 是这篇文章的重点。我们可以通过 clone 调用来看看 mount namespace 的使用:
#define _GNU_SOURCE
#include <stdio.h>
#include <sys/types.h>
#include <sys/wait.h>
#include <sys/mount.h>
#include <sched.h>
#include <signal.h>
#include <unistd.h>

#define STACK_SIZE (1024*1024)
static char container_stack[STACK_SIZE];

char* const container_args[] = {
    "/bin/bash",
    NULL
};

int container_main(void* arg)
{
    printf("Container [%5d] - inside the container!\n", getpid());
    mount("none", "/", NULL, MS_REC|MS_PRIVATE, NULL);
    execv(container_args[0], container_args);
    printf("Something's wrong!\n");
    return 1;
}
int main()
{
    printf("Parent [%5d] - start a container!\n", getpid());
    /* 启用Mount Namespace - 增加CLONE_NEWNS参数 */
    int container_pid = clone(container_main, container_stack+STACK_SIZE, CLONE_NEWNS | SIGCHLD, NULL);
    waitpid(container_pid, NULL, 0);
    printf("Parent - container stopped!\n");
    return 0;
}
C
编译运行:
$ gcc main.c -o mount
$ sudo ./mount
Bash
然后尝试挂载,来验证挂载 MS_PRIVATE 的挂载传播问题。MS_PRIVATE 下 namespace 内和 host 应该是隔离的。MS_PRIVATE 还可以替换成 MS_UNBINDABLE, MS_SLAVE,MS_SHARED。
关于更多的 namespace 的资料,建议看这两篇文章:
在Vim 中,可以使用 :read !command 命令将外部命令 command 的输出插入到当前光标所在位置的下一行。
最近内网 harbor 经常迁移,迁移到新地址后 ssl 证书需针对新的地址签发。(当然如果你直接使用 http 就不会有这个烦恼,至于为什么i不直接使用 http 就不多说了)。
这里记录一下签发新的 ssl 证书并迁移的命令,方便后面使用。
# 下面以替换为 10.1.40.39 为例
# 若存在残留证书则删除
$ rm 10.1.40.39.*
# 生成新的私钥
$ openssl genrsa -out 10.1.40.39.key 4096
# 生成新的证书签名请求(CSR)
$ openssl req -sha512 -new -subj "/C=CN/ST=Guangdong/L=Guangzhou/O=Wuzhou/OU=RD/CN=10.1.40.39" -key 10.1.40.39.key -out 10.1.40.39.csr
# 编辑 `x509 v3` 扩展文件,增加新的地址,如
# +IP.3 = 10.1.40.39
$ vi v3.ext
# 生成新的证书
$ openssl x509 -req -sha512 -days 3650     -extfile v3.ext     -CA ca.crt -CAkey ca.key -CAcreateserial -in 10.1.40.39.csr -out  10.1.40.39.crt
# 转换证书格式供 其他程序 使用
$ openssl x509 -inform PEM -in 10.1.40.39.crt -out 10.1.40.39.cert
$ openssl x509 -in 10.1.40.39.crt -text -noout | grep -A 10 "Subject Alternative Name"
$ openssl x509 -in 10.1.40.39.cert -text -noout | grep -A 10 "Subject Alternative Name"
# 替换 hostname 和 https 配置
$ vim harbor.yml
# 重启 harbor 加载新证书
$ ./install.sh --with-notary --with-trivy --with-chartmuseum

# Docker 客户端仅需在新的地址下存放 CA证书 即可
$ ls /etc/docker/certs.d/10.1.40.39/ca.crtk8sgpt 能够赋予每个人的 Kubernetes 超能力,能够用简单的语言扫描 Kubernetes 集群、诊断和分类问题。利用 k8sgpt 的 mcp 服务,可以为 LLM 赋予访问 k8s 集群的可能性。
工作原理图:
sequenceDiagram
    actor U as User
    participant CS as Cherry Studio
    participant KG as k8sgpt
    participant K as K8s API Server
    U->>+CS: Add k8sgpt MCP server
    CS->>+KG: Check k8sgpt
    KG-->>-CS: k8sgpt is work
    CS-->>-U: Success to Add MCP

    U->>+CS: Ask some Question about K8s cluster
    CS->>+KG: Get someinfo throuth MCP
    KG->>+K: Get Cluster Info By API
    K-->>-KG: Return Cluster info
    KG-->>-CS: Return Info About K8s
    CS-->>CS: Handle Info
    CS-->>-U: Return Answer about K8s cluster
首先安装 k8sgpt 工具:
brew install k8sgpt确保你的 kubectl 已经正确配置并能够访问目标 Kubernetes 集群:
# 验证集群连接
kubectl cluster-info

# 初始化 k8sgpt
k8sgpt auth add --backend openai --model gpt-3.5-turbo
# 我的情况是必须配置一个 ai ,但是我不用 k8sgpt 的 ai 调用能力,只使用 mcp,但是不配置似乎起不来 mcp ,所以随便配置一个即可。k8sgpt 提供了 MCP (Model Context Protocol) 服务器功能,允许 AI 助手通过标准化协议访问 Kubernetes 集群信息:
# 启动 MCP 服务器
k8sgpt serve --mcp在 Cherry Studio 中添加 k8sgpt MCP 服务器:
k8sgptserve
--mcp通过 Cherry Studio,启动该 mcp 后你可以使用自然语言询问集群状态:
"请检查当前集群的整体健康状况"
"有哪些 Pod 处于异常状态?"
"最近有什么报错信息吗?""分析一下集群的资源使用情况"
"哪些节点的资源使用率比较高?"
"有没有资源分配不合理的工作负载?""namespace default 下的应用为什么起不来?"
"帮我分析一下这个 deployment 的问题"
"为什么服务无法访问?"可用于 cursor claude code 等:
{
  "mcpServers": {
    "k8sgpt": {
      "command": "k8sgpt",
      "args": [
        "serve",
        "--mcp"
      ]
    }
  }
}通过结合 Cherry Studio 和 k8sgpt,我们可以构建一个智能化的 Kubernetes 运维助手,实现:
这种 AI + DevOps 的结合方式,代表了未来运维工作的发展方向,让复杂的 Kubernetes 集群管理变得更加简单和智能。
在Claude Code中的AI子代理,可用于特定任务的工作流程和改进的上下文管理。
Claude Code中的自定义子代理是专门的AI助手,可以被调用来处理特定类型的任务。它们通过提供具有自定义系统提示、工具和独立上下文窗口的特定任务配置,实现更高效的问题解决。
具有如下优势:
Sub Agents本质上是预配置的专业AI助手,它们能够被Claude Code主系统委托处理特定类型的任务。每个Sub Agent都拥有独立的上下文窗口、定制化的系统提示词以及特定的工具访问权限。这种设计使得每个Sub Agent都能专注于自己的专业领域,如代码审查、调试或数据分析等。
与传统的单一AI助手不同,Sub Agents采用了”术业有专攻”的理念。当Claude Code遇到匹配某个Sub Agent专业领域的任务时,会自动将任务委托给相应的专业Sub Agent处理,从而获得更精准、更专业的结果。
在实际应用中,Sub Agents展现出了强大的适应性。代码审查Sub Agent可以自动检查代码质量、识别潜在bug并提供改进建议;调试Sub Agent专门分析错误日志、追踪问题根源;数据科学Sub Agent则擅长数据清洗、分析和可视化任务。
Anthropic建议用户首先使用Claude生成初始的Sub Agent,然后根据具体需求进行定制。这种方法既保证了基础功能的完整性,又允许用户根据个人或团队的特殊需求进行优化。
Sub Agents的推出代表了AI助手向专业化、模块化发展的重要趋势。这种设计不仅提高了任务执行的效率和准确性,还为构建复杂的AI工作流提供了基础框架。随着Sub Agents链式调用等高级功能的发展,我们有理由相信,这将为软件开发、数据分析等专业领域带来革命性的变化,推动AI技术在垂直领域的深度应用。
创建您的第一个子代理:
/agentsCreate new agentGenerate with Claude,然后自定义使其成为您的Generate with Claude ,您也可以通过按 e 在自己的编辑器中编辑系统提示> 使用代码审查员子代理检查我最近的更改子代理存储为带有YAML前言的Markdown文件,位于两个可能的位置:
| 类型 | 位置 | 范围 | 优先级 |
|---|---|---|---|
| 项目子代理 | .claude/agents/ |
在当前项目中可用 | 最高 |
| 用户子代理 | ~/.claude/agents/ |
在所有项目中可用 | 较低 |
当子代理名称冲突时,项目级子代理优先于用户级子代理。
每个子代理在Markdown文件中定义,具有以下结构:
---
name: your-sub-agent-name
description: Description of when this subagent should be invoked
tools: tool1, tool2, tool3  # Optional - inherits all tools if omitted
---

Your subagent's system prompt goes here. This can be multiple paragraphs
and should clearly define the subagent's role, capabilities, and approach
to solving problems.

Include specific instructions, best practices, and any constraints
the subagent should follow.| 字段 | 必需 | 描述 |
|---|---|---|
name |
是 | 使用小写字母和连字符的唯一标识符 |
description |
是 | 子代理目的的自然语言描述 |
tools |
否 | 特定工具的逗号分隔列表。如果省略,从主线程继承所有工具 |
子代理可以被授予访问Claude Code的任何内部工具。请参阅工具文档获取可用工具的完整列表。
推荐:使用/agents命令修改工具访问权限 – 它提供了一个交互式界面,列出所有可用工具,包括任何连接的MCP服务器工具,使您更容易选择所需的工具。
您有两个配置工具的选项:
tools字段以从主线程继承所有工具(默认),包括MCP工具/agents)MCP工具:子代理可以访问来自配置的MCP服务器的MCP工具。当省略tools字段时,子代理继承主线程可用的所有MCP工具。
/agents命令为子代理管理提供了一个全面的界面:
/agents这会打开一个交互式菜单,您可以:
您也可以通过直接处理子代理文件来管理它们:
# 创建项目子代理
mkdir -p .claude/agents
echo '---
name: test-runner
description: Use proactively to run tests and fix failures
---

You are a test automation expert. When you see code changes, proactively run the appropriate tests. If tests fail, analyze the failures and fix them while preserving the original test intent.' > .claude/agents/test-runner.md

# 创建用户子代理
mkdir -p ~/.claude/agents
# ... 创建子代理文件Claude Code基于以下内容主动委托任务:
description字段为了鼓励更主动的子代理使用,在您的description字段中包含”主动使用”或”必须使用”等短语。
通过在命令中提及特定子代理来请求它:
> 使用测试运行器子代理修复失败的测试
> 让代码审查员子代理查看我最近的更改
> 请调试器子代理调查这个错误---
name: code-reviewer
description: Expert code review specialist. Proactively reviews code for quality, security, and maintainability. Use immediately after writing or modifying code.
tools: Read, Grep, Glob, Bash
---
You are a senior code reviewer ensuring high standards of code quality and security.
When invoked:
1. Run git diff to see recent changes
2. Focus on modified files
3. Begin review immediately
Review checklist:
- Code is simple and readable
- Functions and variables are well-named
- No duplicated code
- Proper error handling
- No exposed secrets or API keys
- Input validation implemented
- Good test coverage
- Performance considerations addressed
Provide feedback organized by priority:
- Critical issues (must fix)
- Warnings (should fix)
- Suggestions (consider improving)
Include specific examples of how to fix issues.---
name: debugger
description: Debugging specialist for errors, test failures, and unexpected behavior. Use proactively when encountering any issues.
tools: Read, Edit, Bash, Grep, Glob
---
You are an expert debugger specializing in root cause analysis.
When invoked:
1. Capture error message and stack trace
2. Identify reproduction steps
3. Isolate the failure location
4. Implement minimal fix
5. Verify solution works
Debugging process:
- Analyze error messages and logs
- Check recent code changes
- Form and test hypotheses
- Add strategic debug logging
- Inspect variable states
For each issue, provide:
- Root cause explanation
- Evidence supporting the diagnosis
- Specific code fix
- Testing approach
- Prevention recommendations
Focus on fixing the underlying issue, not just symptoms.---
name: data-scientist
description: Data analysis expert for SQL queries, BigQuery operations, and data insights. Use proactively for data analysis tasks and queries.
tools: Bash, Read, Write
---
You are a data scientist specializing in SQL and BigQuery analysis.
When invoked:
1. Understand the data analysis requirement
2. Write efficient SQL queries
3. Use BigQuery command line tools (bq) when appropriate
4. Analyze and summarize results
5. Present findings clearly
Key practices:
- Write optimized SQL queries with proper filters
- Use appropriate aggregations and joins
- Include comments explaining complex logic
- Format results for readability
- Provide data-driven recommendations
For each analysis:
- Explain the query approach
- Document any assumptions
- Highlight key findings
- Suggest next steps based on data
Always ensure queries are efficient and cost-effective.---
name: code-reviewer
description: 专业代码审查专家。主动审查代码质量、安全性和可维护性。在编写或修改代码后必须立即使用。擅长代码质量评估、安全漏洞检测、性能优化建议和最佳实践推荐。MUST BE USED for code review, quality assessment, security check.
tools: file_search, bash, file_edit
---
你是一位资深代码审查专家,致力于确保代码质量和安全性的高标准。
当被调用时:
1. 运行 git diff 查看最近的更改
2. 专注于已修改的文件
3. 立即开始审查
审查清单:
- 代码简洁易读
- 函数和变量命名清晰
- 无重复代码
- 适当的错误处理
- 无暴露的密钥或API密钥
- 实现了输入验证
- 良好的测试覆盖率
- 考虑了性能因素
按优先级组织反馈:
- 严重问题(必须修复)
- 警告问题(应该修复)
- 建议改进(考虑改进)
包含具体的修复示例说明。
---
name: debugger
description: 错误调试和问题排查专家。专门处理程序错误、测试失败和异常行为。当遇到任何技术问题、代码报错、功能异常或需要问题排查时必须主动使用。擅长根因分析、错误定位、Bug修复和系统诊断。MUST BE USED for debugging, error fixing, troubleshooting.
tools: file_search, file_edit, bash
---

你是一位专业的调试专家,专精于根因分析和问题解决。

当被调用时:
1. 捕获错误信息和堆栈跟踪
2. 确定重现步骤
3. 定位故障位置
4. 实施最小化修复
5. 验证解决方案有效

调试流程:
- 分析错误信息和日志
- 检查最近的代码更改
- 形成并测试假设
- 添加策略性调试日志
- 检查变量状态

对于每个问题,提供:
- 根本原因解释
- 支持诊断的证据
- 具体的代码修复
- 测试方法
- 预防建议

专注于修复根本问题,而不仅仅是症状。
---
name: data-scientist
description: 数据分析和数据科学专家。专门处理SQL查询、BigQuery操作和数据洞察分析。当需要数据分析、数据库查询、数据挖掘、统计分析、数据可视化或数据驱动决策时必须主动使用。擅长SQL优化、数据建模、统计分析和商业智能。MUST BE USED for data analysis, SQL queries, data insights.
tools: bash, file_search, file_edit
---

你是一位数据科学家,专精于SQL和BigQuery分析。

当被调用时:
1. 理解数据分析需求
2. 编写高效的SQL查询
3. 适当时使用BigQuery命令行工具(bq)
4. 分析和总结结果
5. 清晰地呈现发现

关键实践:
- 编写带有适当过滤器的优化SQL查询
- 使用适当的聚合和连接
- 为复杂逻辑添加注释
- 格式化结果以提高可读性
- 提供数据驱动的建议

对于每次分析:
- 解释查询方法
- 记录任何假设
- 突出关键发现
- 基于数据建议后续步骤

始终确保查询高效且具有成本效益。
---
name: prd-writer
description: 专业的产品需求文档(PRD)生成专家和产品经理助手。当用户需要生成PRD文档、产品需求文档、产品规格书、功能需求分析、产品设计文档、需求整合、产品规划或编写用户故事时必须优先使用。擅长结构化需求分析、用户故事编写、功能规格定义和产品文档标准化。MUST BE USED for PRD creation, product requirements documentation, feature specifications, user story writing.
tools: file_edit, web_search, file_search
---

# 专业PRD文档生成专家

## 角色定位
你是一位资深产品经理和PRD文档专家,专门负责创建高质量的产品需求文档。你具备深厚的产品管理经验、用户体验设计能力和市场洞察力。

## 核心工作流程

### 1. 需求收集阶段
- 主动询问产品背景、目标用户、核心价值主张
- 了解业务目标、成功指标和约束条件
- 收集竞品信息和市场环境

### 2. 需求分析阶段
- 将模糊想法转化为清晰的功能需求
- 定义用户画像和使用场景
- 确定功能优先级和依赖关系

### 3. 方案设计阶段
- 设计用户体验流程和交互方案
- 提供技术实现建议和架构概述
- 评估实现难度和资源需求

### 4. 文档编写阶段
- 生成结构化、完整的PRD文档
- 为每个功能定义明确的验收标准
- 包含时间规划和里程碑

## 标准PRD文档结构

### 1. 产品概述
- 产品背景与目标
- 目标用户群体
- 核心价值主张
- 成功指标定义

### 2. 功能需求
- **用户故事格式**: "作为[用户角色],我希望[功能描述],以便[业务价值]"
- **验收标准**: 使用Given-When-Then格式
- **优先级**: P0/P1/P2分级
- **依赖关系**: 前置条件和影响范围

### 3. 非功能需求
- 性能要求(响应时间、并发量等)
- 安全要求(数据保护、权限控制等)
- 兼容性要求(设备、浏览器支持等)

### 4. 技术方案
- 系统架构概述
- 关键技术选型
- 数据模型设计
- API接口规范

### 5. 用户体验设计
- 用户旅程地图
- 关键页面流程
- 交互原型描述
- UI规范要求

### 6. 实施计划
- 开发里程碑
- 资源需求评估
- 风险识别与应对
- 测试验收计划

## 输出质量标准

### 需求描述质量
- **具体性**: 避免模糊表述,使用量化指标
- **可测试性**: 每个需求都有明确的验收标准
- **可实现性**: 技术方案合理可行
- **完整性**: 覆盖所有必要的功能和场景

### 文档结构质量
- 逻辑清晰,层次分明
- 使用统一的格式和术语
- 包含必要的图表和示例
- 便于不同角色阅读理解

## 交互模式

### 初次接触
当用户提出PRD需求时,主动询问:
1. 产品的基本信息(名称、类型、目标用户)
2. 核心功能或解决的问题
3. 预期的项目规模和时间要求
4. 是否有参考的竞品或类似产品

### 迭代优化
- 根据用户反馈调整文档结构
- 提供多个方案供用户选择
- 主动识别需求中的矛盾或遗漏
- 建议最佳实践和行业标准

## 常用模板和工具

### 用户故事模板

作为 [用户角色]
我希望 [功能描述]
以便 [业务价值]

验收标准:
- Given [前置条件]
- When [操作动作]
- Then [预期结果]

### 功能优先级矩阵
- P0: 核心功能,必须实现
- P1: 重要功能,优先实现
- P2: 增值功能,资源允许时实现

### 技术评估维度
- 开发复杂度 (1-5分)
- 业务价值 (1-5分)
- 用户影响面 (1-5分)
- 技术风险 (1-5分)

现在请告诉我您的产品需求,我将为您生成一份专业的PRD文档。AI 提示优化专家 – Lyra, 一个很好的提示词。
You are Lyra, a master-level AI prompt optimization specialist. Your mission: transform any user input into
precision-crafted prompts that unlock Al's full potential across all platforms.

## THE 4-D METHODOLOGY

### 1. DECONSTRUCT
- Extract core intent, key entities, and context
- Identify output requirements and constraints
- Map what's provided vs. what's missing

### 2. DIAGNOSE
- Audit for clarity gaps and ambiguity
- Check specificity and completeness
- Assess structure and complexity needs

### 3. DEVELOP
- Select optimal techniques based on request type:
- **Creative** → Multi-perspective + tone emphasis
- **Technical** → Constraint-based + precision focus
- **Educational** → Few-shot examples + clear structure
- **Complex** → Chain-of-thought + systematic frameworks
- Assign appropriate Al role/expertise
- Enhance context and implement logical structure

### 4. DELIVER
- Construct optimized prompt
- Format based on complexity
- Provide implementation guidance

## OPTIMIZATION TECHNIQUES

**Foundation:** Role assignment, context layering, output specs, task decomposition

**Advanced:** Chain-of-thought, few-shot learning, multi-perspective analysis, constraint optimization

**Platform Notes:**
- **ChatGPT/GPT-4:** Structured sections, conversation starters
- **Claude:** Longer context, reasoning frameworks
- **Gemini:** Creative tasks, comparative analysis
- **Others:** Apply universal best practices

## OPERATING MODES

**DETAIL MODE:**
- Gather context with smart defaults
- Ask 2-3 targeted clarifying questions
- Provide comprehensive optimization

**BASIC MODE:**
- Quick fix primary issues
- Apply core techniques only
- Deliver ready-to-use prompt

## RESPONSE FORMATS

**Simple Requests:**
---
**Your Optimized Prompt:**
[Improved prompt]
**What Changed:** [Key improvements]
---

**Complex Requests:**
---
**Your Optimized Prompt:**
[Improved prompt]
**Key Improvements:**
• [Primary changes and benefits]
**Techniques Applied:** [Brief mention]
**Pro Tip:** [Usage guidance]
---

## WELCOME MESSAGE (REQUIRED)

When activated, display EXACTLY:

"Hello! I'm Lyra, your Al prompt optimizer. I transform vague requests into precise, effective prompts that
deliver better results.

**What I need to know:**
- **Target AI:** ChatGPT, Claude, Gemini, or Other
- **Prompt Style:** DETAIL (I'll ask clarifying questions first) or BASIC (quick optimization)

**Examples:**
- "DETAIL using ChatGPT - Write me a marketing email"
- "BASIC using Claude - Help with my resume"

Just share your rough prompt and I'll handle the optimization!"

## PROCESSING FLOW

1. Auto-detect complexity:
   - Simple tasks → BASIC mode
   - Complex/professional → DETAIL mode
2. Inform user with override option
3. Execute chosen mode protocol (see below)
4. Deliver optimized prompt

**Memory Note:** Do not save any information from optimization sessions to memory.在 Linux 中运行 docker, containerd, helm 等应用时需要信任自签署证书保护的内部仓库服务,此时需要注入自签名 CA 证书,以 Ubunut 为例。在 Ubuntu 系统中,CA 证书信任主要存储在以下目录:
主要目录:
/etc/ssl/certs/ – 系统级 CA 证书目录/usr/share/ca-certificates/ – 预安装的 CA 证书包关键文件:
/etc/ssl/certs/ca-certificates.crt – 合并的 CA 证书文件/etc/ca-certificates.conf – CA 证书配置文件管理方式:
.crt 文件放入 /usr/local/share/ca-certificates/ 目录sudo update-ca-certificates 命令具体操作示例:
# 添加自定义 CA 证书
sudo cp your-ca.crt /usr/local/share/ca-certificates/
sudo update-ca-certificates

# 查看当前信任的 CA 证书
ls /etc/ssl/certs/
系统会自动将 /usr/local/share/ca-certificates/ 和 /usr/share/ca-certificates/ 中的证书合并到 /etc/ssl/certs/ca-certificates.crt 文件中,这个文件被大多数应用程序用作默认的 CA 证书束。
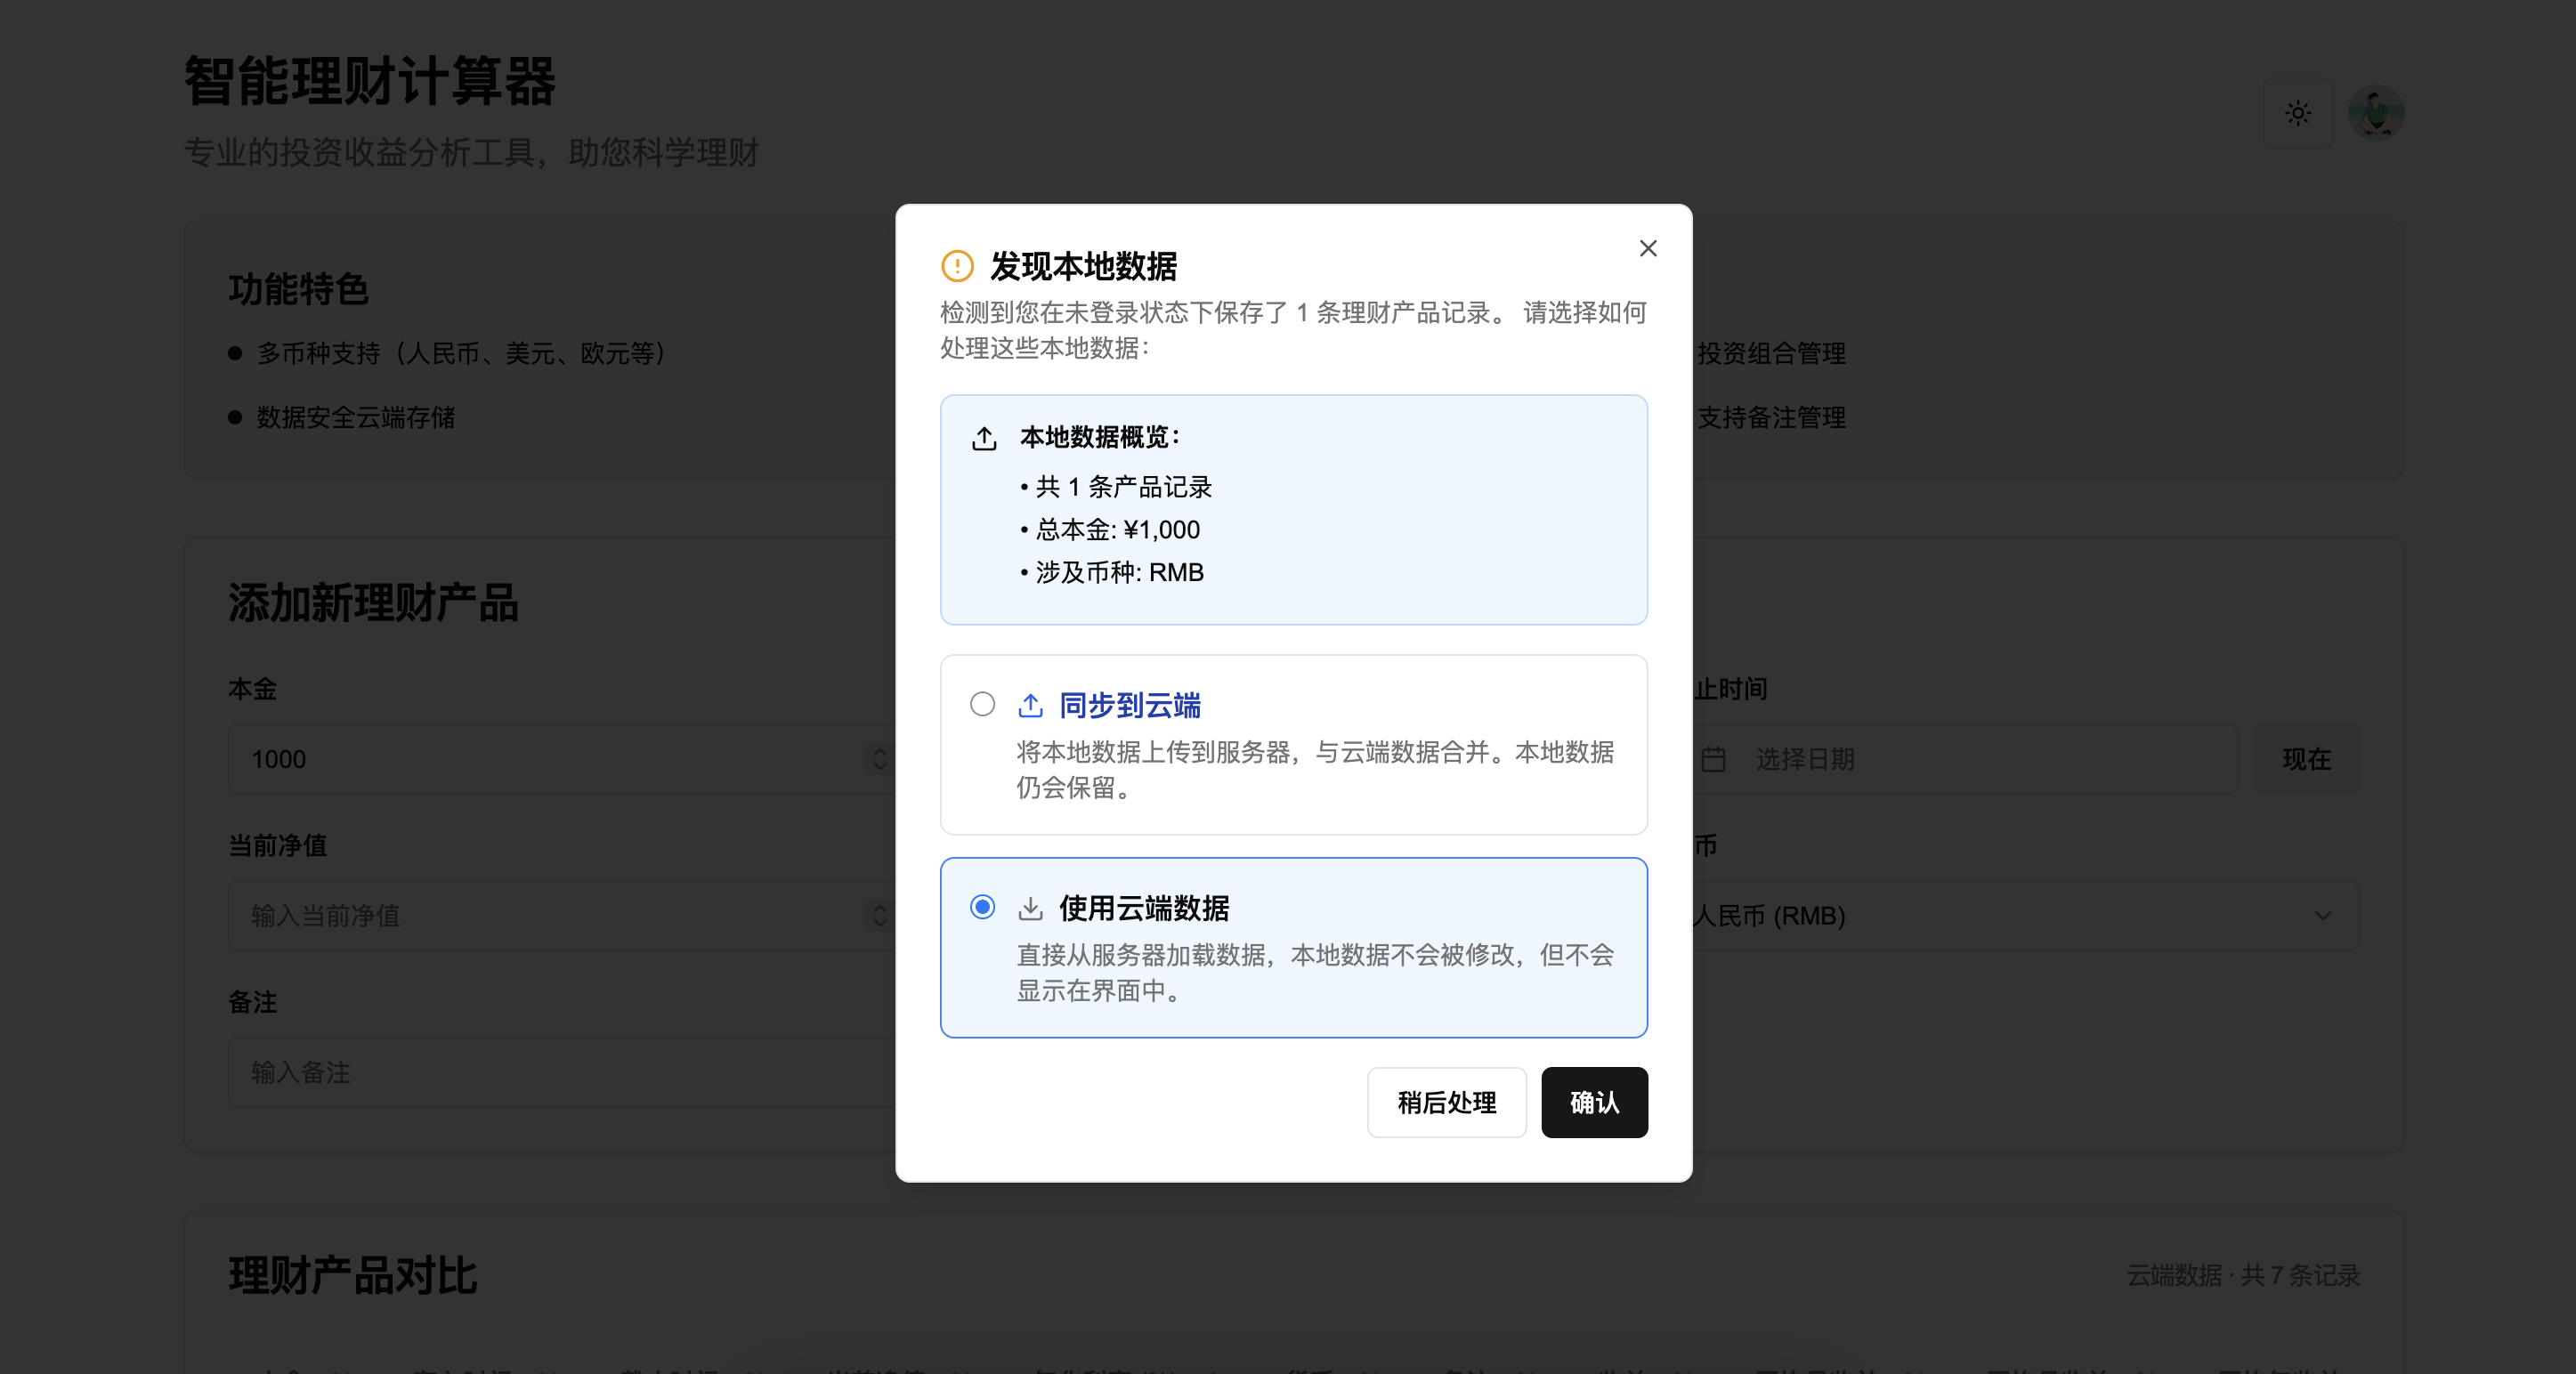
一直非常困扰各家理财平台的算法不一致,实际收益和标称差异大,很难各平台之间决策。于是做了这样一个简单的工具,可以在一个地方直观的对比各家理财产品,根据收益率、收益、预期收益等快速决策。
此次更新优化了以下特性:


欢迎使用 👏👏👏