茶余饭后 #1

突发奇想,是不是可以撰写一个我个人的类似《青年文摘》的专刊,每天将自己看过有感悟的文字、链接之类的记录下来。记录下此时此刻的感受,以前也想做类似的事情,但总感觉自己阅历不够、水平不够,很多东西可能其他人早就看过了,没什么价值。但是现在越来越多的看到一些自己熟悉的东西,一些东西就算看过,每个人都有不同的视角。另一个角度看,同样的东西在不同阶段提起,也会有不同的感受。我们需要这样的契机,来反复体会“经典”的力量。

所以就有了这专刊《茶余饭后》,我会在自己的日记软件 Diarum 中记录自己看过有感触的一些内容,然后将这些内容简单整理后发布,希望能留下一些属于自己对世界的理解。

《科技爱好者周刊(第 417 期):不要让 AI 代表你》

refs: https://www.ruanyifeng.com/blog/2026/10/weekly-issue-417.html

(1)不要让 AI 代表你

不要让 AI 代表你,原因很简单。因为 AI 的行为模式是循环尝试,会穷尽所有可能的方式,尝试完成你交给它的任务,而且这样一遍遍的尝试,对 AI 来说几乎不产生成本。

但是,人类的社会系统是为人设计的,不是为 AI 这种行为模型设计的。如果大量的人授权 AI 代表自己行事,社会运作将瘫痪,因为人力无法处理 AI 发起的海量请求,最终只能让 AI 去对付 AI。

到了那个时候,你再想找真人来帮你解决问题,就不可能了。

但是总感觉,这是一个必然的路。未来必然越来越找到真人。有点悲观主义。

但是这或许是一个好的习惯,分辨一个人又多了一个维度,即 AI 度。

《为什么核潜艇导航几乎不用 GPS?》

refs: https://mp.weixin.qq.com/s/vI2yz3RaH-XYA2wYyBmFnQ

看这篇文章实在太有体会了。

对于外部设施的依赖,造就了当前这个繁荣的市场。但这种外部依赖是脆弱的。

许多时候,本着先把东西做出来,再优化的态度。但是当东西做出来了,这个东西也不值得再去优化了。这就是很多时候的现实。或许从一开始,就注定是这个结局。不是所有事情,都值得从一开始就认真对待;更不是所有事情,都值得在后面反复迭代。这其中的差异,取决于很多东西。

看这篇文章特别有感触,对于核潜艇这种战略武器,需要考虑最极端情况下的表现。因此就不能依赖 GPS/GNSS 这种现代化的简单方案,必须有一套完全依赖自身的强大基础设施。

我自己在编写程序的时候会很深刻的思考这个问题。很多时候一个架构决策,决定了后期相差数倍的运营成本、维护成本还有风险成本。为了降低成本和风险,我更多时候倾向于自给自足,尽可能减少外部依赖,尽可能依赖可控可靠的基础设施。在这中间我会比大部分人思考更多问题,而这些问题几乎是极少数人才能理解的。

这个公众号归属地还是郑州,我呆了快6年的地方,感情深厚的土地。

《37岁才明白的事》

refs: https://mp.weixin.qq.com/s/eZ4Btny9ZFVL_gACyoxaZw

看这篇文章有好几点感悟:

(1)“像投资一样小心花费注意力,像吃霸王餐一样挥霍自己的表达欲”。

这段话很有感悟。我是一个表达欲时而丰富时而匮乏的人。比如现在这个时刻会很想写点什么,所以看到这段话就超级有感悟。就像吃饭一样,有时候饿了,有时候不饿。饿了,就可以让自己饱餐一顿,吃饱饭才是正事。不饿的时候,就少吃一些,不要让自己饿的不行就好了。所以,在想写东西的时候,就大大方方写下来吧。

因为职场的缘故,我在刻意减少自己写出的东西。因为之前经历过一次或许不是很合适的面试,聊了一个多小时,然后找了一个很小的点否掉了全部。下来我就觉得很奇怪,如果真不想招人,花这么久时间做什么呢。如果想招人,就因为一个小知识点没回答上来就否掉,也有点奇怪了。不管这么多了。但是这位面试官说把我简历上的技术博客全部看完了,我还是很震惊的。但是他表示有些内容他并不认同。具体不认同什么,也没说什么。

所以后面我就不想太多的表达自己了。就是担心再被一些断章取义者,从一大段文字中找到一点细微的东西来作为武器攻击我。但是不写东西,没有释放自己的表达欲,也是很难受的一件事情,等于我放弃了触达那些真正气场合适人们的机会。我不能因为一些观念不和人的言论,放弃了寻找观念相和人们的机会。

所以现在,我重新开始写东西了,希望你喜欢。

(2)注意力是太重要的东西了。

前阵子出去放松了几天。有5天左右的时间远离“大城市”,切身感受到了小城市的节奏。在这里,太阳下山之后,就很少有灯光了,人们简单的餐饮过后就可以准备休息了。等太阳出来,就是新一天的惊艳的美景。这感觉太神奇了,可以慢悠悠的起床、睡觉,慢悠悠的走走,没有多少人是在步履匆匆的赶路,赚的钱不多,但足够生活的很好。

再次回到工作的城市,又开始快节奏,感觉每天的时间被各种事情天然的掏空,每天又有特别过载的信息要去阅读。所以越发的感觉注意力的珍贵。

在这个 ai 盛行的时代里,内容进一步爆炸,有好多东西几乎一眼 ai, 有的不得不读一下,有的可以滑走的就不看。能看到一些高质量的、接地气的文字,真的不容易。

所以管理好自己的注意力,好好的利用,注意力放在的地方,几乎就是我们未来会成为的样子。

(3)真正的成长,就是不再一味寻求被认可或喜爱

这一点也比较认同。作为小孩的时候得到大人的认同是很重要的,甚至成为一种用尽全身力气的生存之道。但是当自己成为大人,开始承担更大的责任,事情就不一样了。在现实社会中充满了冲突和误解,充满了对抗和背刺。每天要面对太多“离谱”的事情,还要去心平气和的处理,实在是不容易。若过载这种情况下,还用外部反馈来评判自己,那就是对自己的一种残忍。

任何时候,都要找到真正的榜样,认定正确的是事情然后坚持下去。不要摇摆,不要受外部蛊惑。要看清楚到底是水平不够的人在忽悠人,还是真正有价值的内容在低调的表述。我们要对低水平的冲突有足够的钝感,对高质量的内容有更高的敏感度。只有这样,我们才能在这个纷扰的世界活成更好的样子。

(4)你想活出怎样的人生?

之前看过这个电影,但是那时的自己有点看的似懂非懂。

或许到某个阶段,在看这个电影,或是思考这个问题,就有完全不同的感受了吧。
专业的网络延迟波动检测工具 irtt

irtt 专门测长期延迟稳定性和抖动,按固定间隔发包(如每 10ms 一个),统计 RTT、单向延迟、IPDV(抖动)和丢包。它比 ping 精确得多,很适合跑几小时甚至几天的稳定性测试。

相比于传统的 ICMP (Ping) 测试,IRTT 采用 UDP 能够更真实地模拟 VoIP、在线游戏等实时业务的流量,并能同时测量出双向丢包、单向延迟 (OWD) 以及抖动 (IPDV) 等深度指标。

irtt server
irtt client -i 10ms -d 1h -l 64 
<server_ip> -o result.json

在 alpine 下安装:

echo "@edgecommunity http://mirrors.ustc.edu.cn/alpine/edge/community" >> /etc/apk/repositories
apk update
apk add irtt@edgecommunity

其他系统按需安装。

也可以这样纯静态交叉编译后放到目标机器中使用:

$ git clone https://github.com/heistp/irtt.git
$ cd irtt
$ CGO_ENABLED=0 GOOS=linux GOARCH=arm64 go build -ldflags="-s -w -extldflags '-static'" -o irtt_linux_arm64 ./cmd/irtt

效果:

seq=1213 rtt=270µs rd=1.9s sd=-1.9s ipdv=71.5µs
seq=1214 rtt=254µs rd=1.9s sd=-1.9s ipdv=15.3µs
seq=1215 rtt=283µs rd=1.9s sd=-1.9s ipdv=28.3µs
interrupt
                        Min    Mean  Median     Max  Stddev
                        ---    ----  ------     ---  ------
                RTT   171µs   280µs   273µs  3.74ms   111µs
         send delay   -1.9s   -1.9s   -1.9s   -1.9s   105µs
      receive delay    1.9s    1.9s    1.9s    1.9s  18.9µs

      IPDV (jitter)   180ns  49.2µs    33µs  3.52ms   147µs
          send IPDV    63ns  41.1µs  26.4µs  3.45ms   143µs
       receive IPDV    30ns  18.2µs  13.8µs   158µs  17.7µs

     send call time  10.5µs  20.5µs           127µs  9.05µs
        timer error    76ns   258µs           925µs   159µs
  server proc. time  2.95µs  6.57µs          53.8µs  2.55µs

                duration: 12.2s (wait 0s)
   packets sent/received: 1217/1216 (0.08% loss)
 server packets received: 1216/1217 (0.08%/0.00% loss up/down)
     bytes sent/received: 77888/77824
       send/receive rate: 51.2 Kbps / 51.2 Kbps
             timer stats: 2/1219 (0.16%) missed, 2.58% error

LXC 热载入设备文件

下面以向运行中的 LXC 容器注入 /dev/vhost-net 为例讲解。

有两种思路:临时注入(容器重启后失效)和永久配置(写入配置)。有时无法重启 lxc 容器,希望配置生效,就可以用临时注入热载入,在写入配置,这样现在就可以用,下次重启后载入配置就不用热载入了。下面介绍方法:

临时注入

(容器运行中,立即生效)

步骤 1:在宿主机上确认设备号

ls -l /dev/vhost-net
# crw-rw-rw- 1 root kvm 10, 238 ... /dev/vhost-net

主设备号通常是 10,次设备号常见为 238(以你机器输出为准)。

如果没有该设备,先加载模块:

modprobe vhost_net

步骤 2:在容器的 devices cgroup 中放行该设备

cgroup v1:

lxc-cgroup -n <容器名> devices.allow "c 10:238 rwm"

cgroup v2(现代发行版默认)没有 devices.allow 文件,设备控制基于 eBPF,lxc-cgroup 一般无法这样动态修改。此时建议改用下面的”永久配置 + 重启”。

步骤 3:在容器内创建设备节点

lxc-attach -n <容器名> -- mknod -m 666 /dev/vhost-net c 10 238

或直接去容器里执行后面的命令即可。

注意:如果是非特权容器,容器内 mknod 通常会被拒绝(用户命名空间中没有 CAP_MKNOD),此时需要用 bind mount 方式或永久配置。

替代:直接 bind mount 设备文件(不需要 mknod)

# 找到容器的 rootfs 路径后,在宿主机上创建目标文件并 bind mount
touch /var/lib/lxc/<容器名>/rootfs/dev/vhost-net
mount --bind /dev/vhost-net /var/lib/lxc/<容器名>/rootfs/dev/vhost-net

(还需要 cgroup 放行,否则容器里访问会得到 Operation not permitted。)

永久配置

编辑 /var/lib/lxc/<容器名>/config(或 ~/.local/share/lxc/...):

# cgroup v1
lxc.cgroup.devices.allow = c 10:238 rwm

# cgroup v2
lxc.cgroup2.devices.allow = c 10:238 rwm

# 自动挂载设备节点
lxc.mount.entry = /dev/vhost-net dev/vhost-net none bind,create=file 0 0

然后重启容器。

解决宝塔安装 PG 失败的问题

在宝塔面板安装 PostgreSQL 时遇到 pgsql_install.sh: 83: Syntax error: Bad fd number 错误,排查发现是我使用的系统 (Debian13) 默认的 /bin/sh 链接到了 dash(常见于 Ubuntu/Debian 系统),而安装脚本中使用了部分 dash 不支持的语法或重定向符号。

错误日志类似下面这样:

pgsql_install.sh: 83: Syntax error: Bad fd number

检索了一下,官方论坛在很早就出现了这个问题,但至今没有很好的解决,因此将解决方案在这里记录一下。

解决方法

可以通过将系统的默认 /bin/sh 临时或永久更改指向 bash 来解决该问题。 

步骤 1:检查当前的 sh 指向 

在终端执行以下命令:

ls -l /bin/sh

如果输出显示指向 dash(例如 /bin/sh -> dash),说明确实是这个原因。 

步骤 2:将 sh 更改为 bash 

执行下面命令将 /bin/sh 重新定向到 /bin/bash:

sudo mv /bin/sh /bin/sh.bk
sudo ln -s /bin/bash /bin/sh

步骤 3:重新在宝塔面板中安装 

更改完成后,回到宝塔面板,重新卸载并再次尝试安装 PostgreSQL 插件及数据库。 

在 DSH 手动启用 OpenCode Go DeepSeek v4.1 新模型

最近在使用 DeepSeek Harness 时,对接 DeepSeek 官方模型,奈何消耗过高,一会儿就几块钱出去了,于是打算对接 opencode go 订阅,但是发现对接时 dsh 一方面没有 dsv4.1 模型,一方面是对接直接报错。

考虑到这个问题应该会很快被解决,但是由于需要立刻用上,就简单整理一下解决方案,出现同样的问题的朋友可以参考一下。

背景

DSH 不维护模型清单,opencode-go 的模型来自上游 @earendil-works/pi-ai 的静态目录。该目录滞后于 OpenCode 实际提供的模型,需要在 ~/.dsh/settings.yaml 手工补充。

但是直接加也不行,会有几个约束:

约束

  1. 不能往内置 opencode-go 路由里直接加模型。 单个 model 条目只接受 name/contextWindow/maxTokens/input/reasoningEfforts/compat,api 和 baseURL 是路由级字段。而 opencode-go 是混合协议路由(27 个模型分属 3 种 wire protocol),新模型无处继承 api,直接加会报:

    model "xxx" needs an api; the installed catalog does not describe it

    在路由级写 api 又会把全部 27 个模型强制成同一协议。解法是新开一条单协议路由。

  2. OpenCode Go 自 2026-09-05 起要求 x-opencode-session 请求头,pi-ai 不发送该头,否则报 400 MissingSessionID。见 discussions#5495。

配置方法

编辑 ~/.dsh/settings.yaml:

注,这里面的随机串记得替换

llm-pi-ai:
  providers:
    opencode-go:
      apiKeyEnv: OPENCODE_GO_API_KEY
    opencode-go-v41:
      displayName: OpenCode Go (V4.1)
      apiKeyEnv: OPENCODE_GO_API_KEY
      api: openai-completions
      baseURL: https://opencode.ai/zen/go/v1
      headers:
        x-opencode-session: dsh-local-<随机串>
      models:
        - id: deepseek-v4.1-flash
          name: DeepSeek V4.1 Flash
          contextWindow: 1000000
          maxTokens: 384000
          input: [ text, image ]
          reasoningEfforts: { low: low, high: high, max: max }
          compat:
            supportsStore: false
            supportsDeveloperRole: false
            maxTokensField: max_tokens
            requiresReasoningContentOnAssistantMessages: true
            thinkingFormat: deepseek

agent-default-model:
  provider: opencode-go-v41
  model: deepseek-v4.1-flash
  reasoningEffort: high

注意:

  • 路由必须放在 providers 字典下,键名即路由名,不要写错层级了。
  • 两条路由共用同一个 apiKeyEnv,无需重复配置凭据。
  • 改动下次请求生效,不必重启。

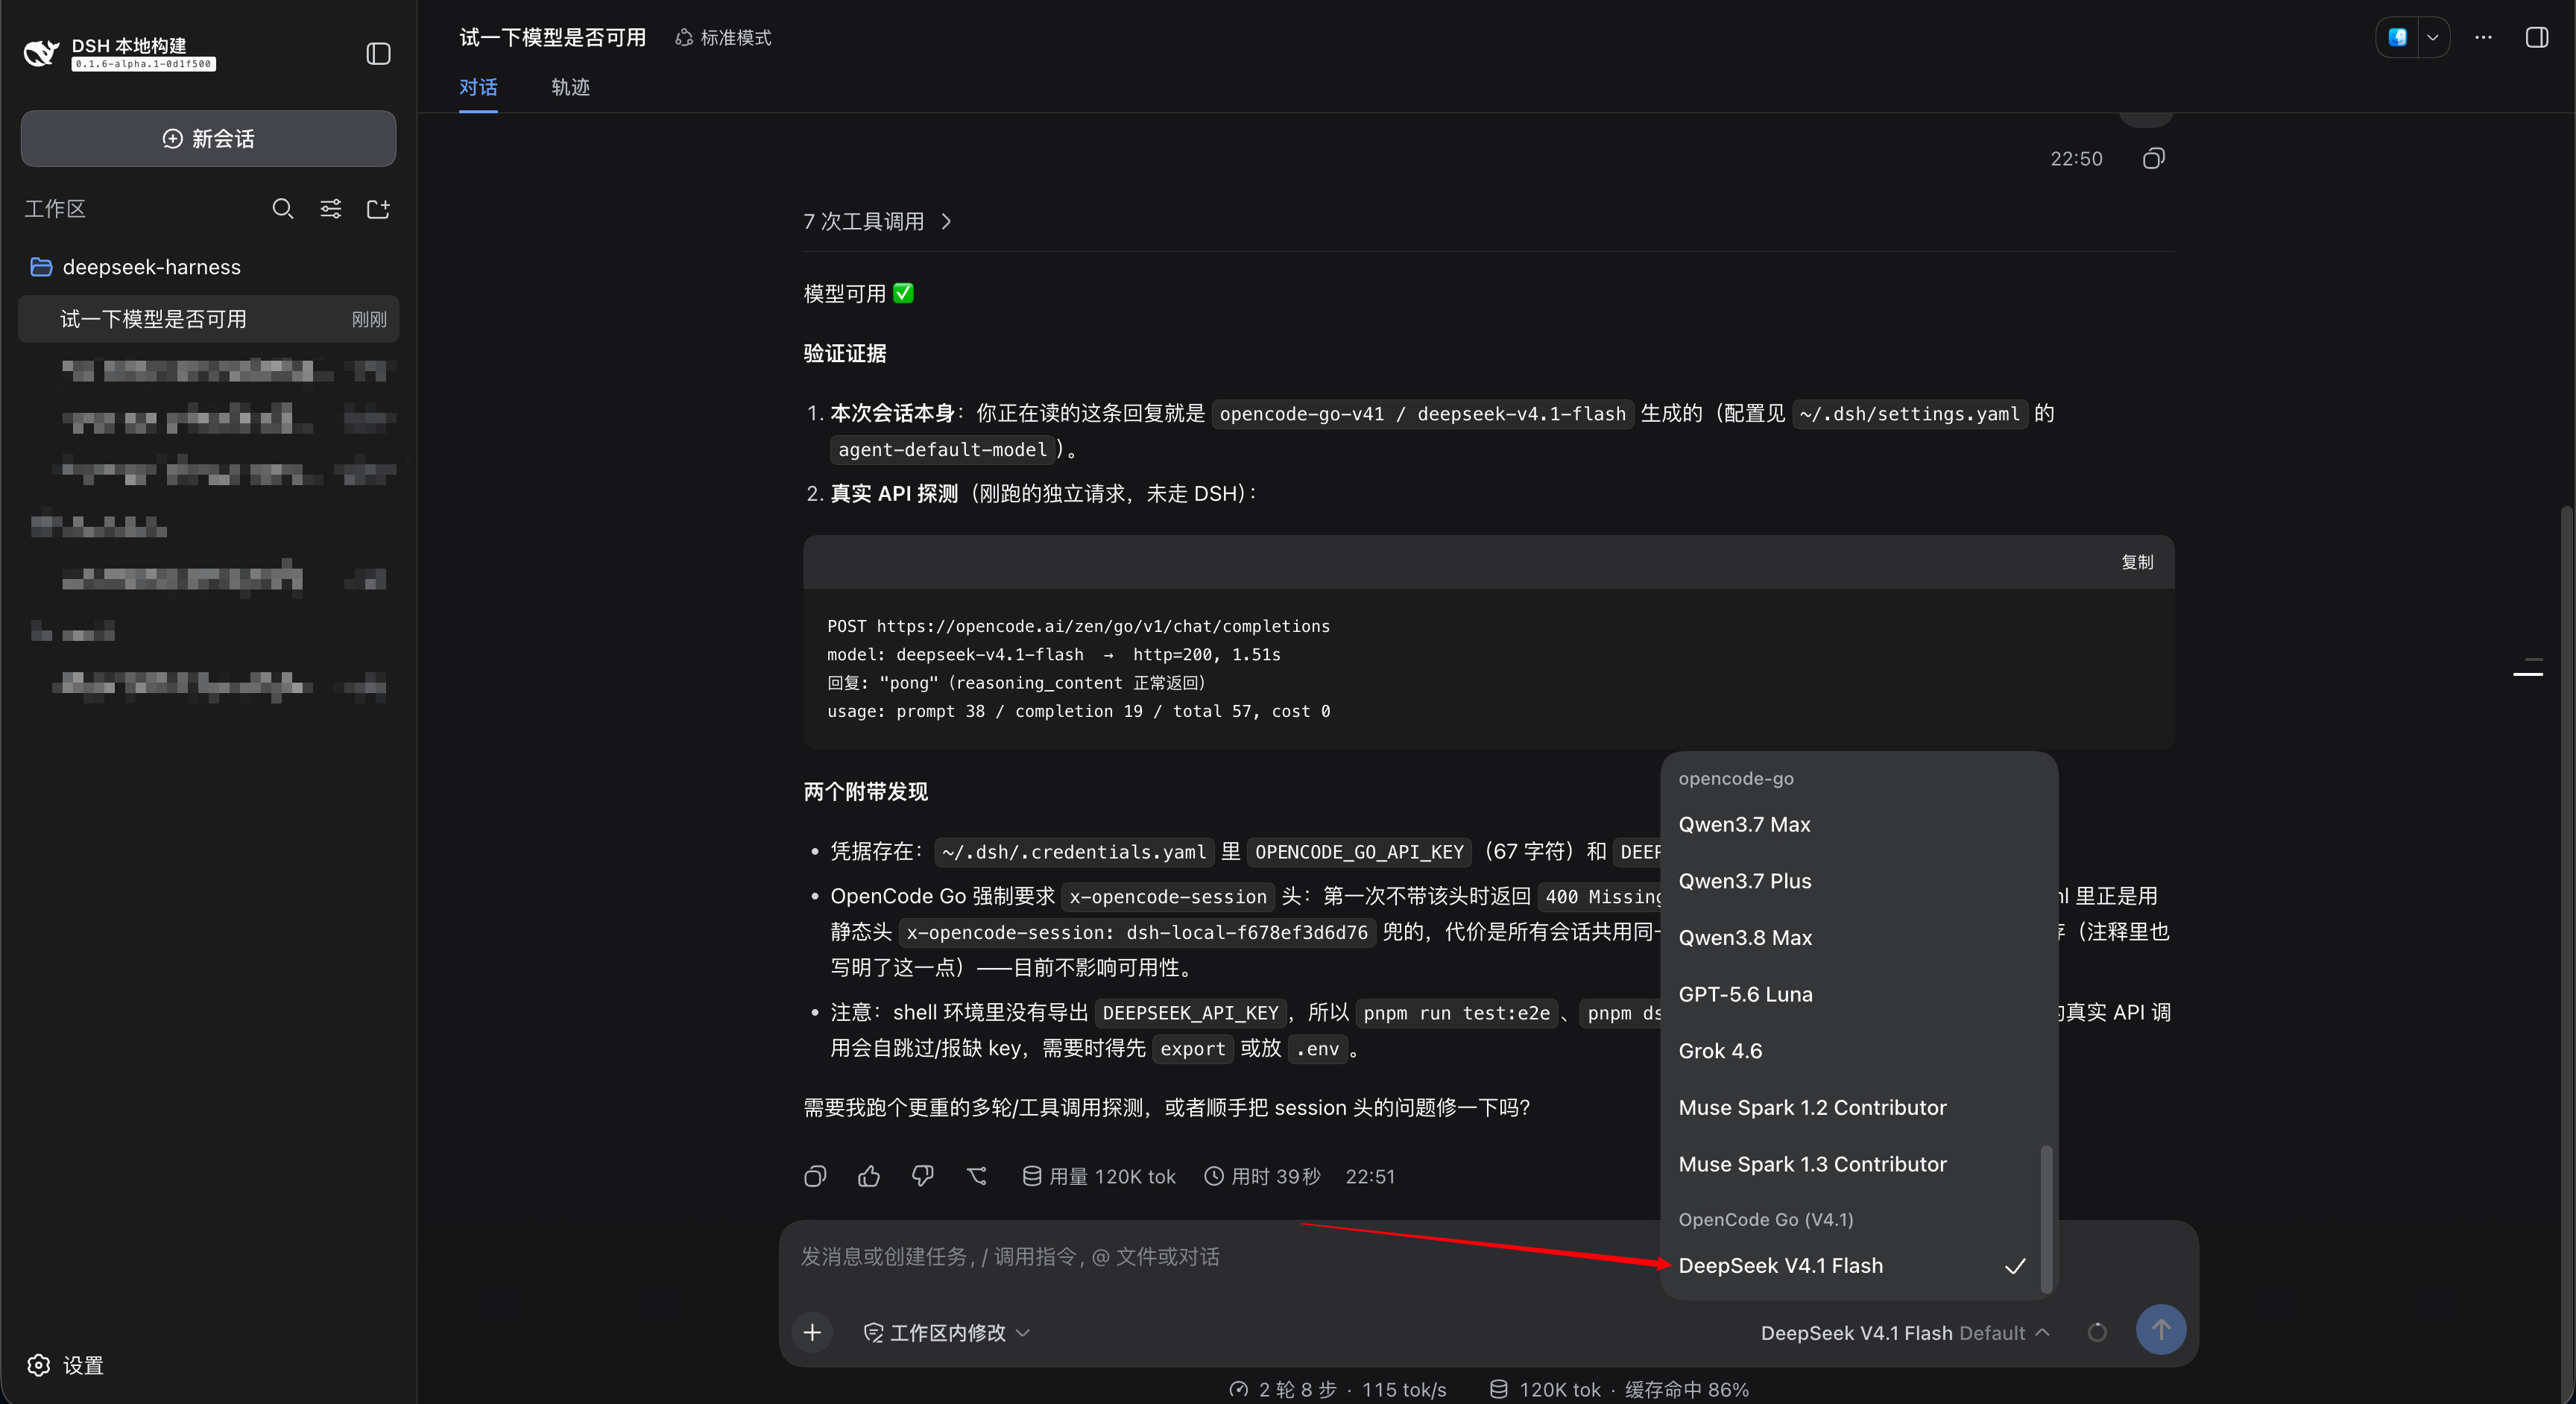
设定后在GUI 模型选择器中会出现 OpenCode Go (V4.1) 分组。

最后就可以正常调用了:

DeepSeek Harness with opencode go ds v4.1

关于 x-opencode-session 的说明

上面用的是静态值,所有会话共用一个 id。能解除 400,但服务端会认为所有对话是同一段,prompt 缓存会失效(该模型缓存读取 $0.003 vs 输入 $0.15,长对话差异明显)。

更好的替代:社区插件 dsh-opencode-session 复用 DSH 会话 id,每会话唯一且跨轮次稳定。

dsh plugin --profile web add dsh-opencode-session

装后删掉配置里的 headers 段。需完全重启 dsh。该插件会 patch 全局 fetch,安装前建议先审查源码。

官方修复进展见 discussions#5495;届时两种 workaround 都可退役。

解决 Linux Wayland 环境下 Joplin 使用 fcitx5 中文输入漏字问题

在 Linux + Wayland 环境下使用 Joplin 时,如果配合 fcitx5 输入中文,可能会遇到输入漏字的问题。

下面这份配置可作为参考:

➜  Downloads cat /usr/share/applications/joplin-desktop.desktop
[Desktop Entry]
Name=Joplin
Comment=Joplin for Desktop
-Exec=/usr/bin/joplin-desktop --gtk-version=3 --ozone-platform=x11
+Exec=/usr/bin/joplin-desktop --gtk-version=3 --ozone-platform-hint=auto --enable-wayland-ime
Terminal=false
Icon=joplin-desktop
StartupWMClass=@joplin/app-desktop
Type=Application
Categories=Office;
MimeType=x-scheme-handler/joplin;
SingleMainWindow=true

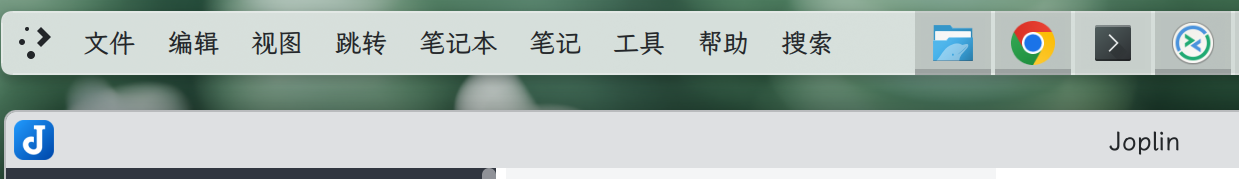
使用 --ozone-platform=x11 可以解决 Joplin 全局菜单不显示的问题,但中文输入时可能会出现漏字。

改用 --ozone-platform-hint=auto --enable-wayland-ime 后,可以解决 fcitx5 中文输入漏字的问题;不过相应地,Joplin 全局菜单可能又无法正常显示。

实测二者不可两全,暂无找到很好的方法。建议先采用第一行配置,显示出来菜单做好配置后,改用第二行配置,确保后期中文输入体现。

输入漏字真的很恼火,如有两全解决方案欢迎讨论。

Refs

修复 Joplin on KDE 菜单栏显示问题

在 KDE 桌面下默认使用全局菜单显示应用程序的菜单栏,但是唯独 Joplin 无法显示。

最后在这里找到了解决方案,下面简单记录:

sudo vim /usr/share/applications/joplin-desktop.desktop 
--Exec=/usr/bin/joplin-desktop
++Exec=/usr/bin/joplin-desktop --gtk-version=3 --ozone-platform=x11

启动程序增加这两个参数即可解决。

Refs

我的博客即将同步至腾讯云开发者社区,邀请大家一同入驻:https://cloud.tencent.com/developer/support-plan?invite_code=21yjpwt8mhhc0

极简但强大的个人财务管理软件 —— 溪流记账(Rivulet)

从开始工作,就一直想开发一款面向个人的财务管理软件,用来直观的分析自己的财务状况,对个人财务情况提供直观的反馈,帮助自己更好的存钱、消费和投资。获取正向反馈,激励自己更好的存钱。

此前,基于 Notion 制作过一套个人财务管理模版,取名 BJ-PFD , 是一长串英文的缩写:Bullet Journal – Personal Finance Dashboard,意为子弹笔记个人财务仪表盘。之前写过一系列的 文章 介绍这套模版。这套模版我个人也一直在用,从2020年到2026年,已经使用了6年了,积累了大量的财务数据,帮助我更好的分析和管理个人财务状况。数据条数也增加到好几千条。此时我发现 Notion 的一些弊端暴露出来了。比如,数据库数量大了以后,加载会比较慢,而且一些数据关联会有极小概率出现问题,导致最终的数据统计出现细微的差错。更重要的一个问题,随着我数据的变多,基于 Notion API 开发的看板工具,启动速度越来越慢了,每次统计数据都要花费数分钟来加载数据。

最近,结合自己之前的工作流和数据模型,使用 AI 辅助编程开发了这款软件。经过一段时间的调试和打磨,这款软件已经能够完美承载我个人目前的财务管理需求,我也将 Notion 中的数千条数据,顺利导入这款新的软件中,数据统计速度从1分钟以上,提升到了1秒以内。现在我已经完全迁移到这款软件上了,使用体验非常好。现在,我希望将这款软件发布出来,分享给更多有需要的人使用。

下面是关于这款软件的介绍:

Rivulet 简介

溪流记账(Rivulet)是一款极简但强大的个人财务管理软件,支持快速记录收支、多账户、多账本与共享账本;提供预算管理、投资记录与财务分析。

Rivulet 使用 GO 和 Svelte 开发,使用 Docker 封装并公开发布,支持 SQLite 和 PostgreSQL 数据库。

更多信息,可以进入 Rivulet 的 官网 或 GitHub Docs仓库 查看,如果有问题可以直接在 留言板 或是 GitHub Docs 仓库的 Issues/Discussions 提出。

Rivulet 功能介绍

  • 支持灵活的流水管理功能,区分支出、收入和转账,并支持灵活的分类,可以方便的进行流水统计;
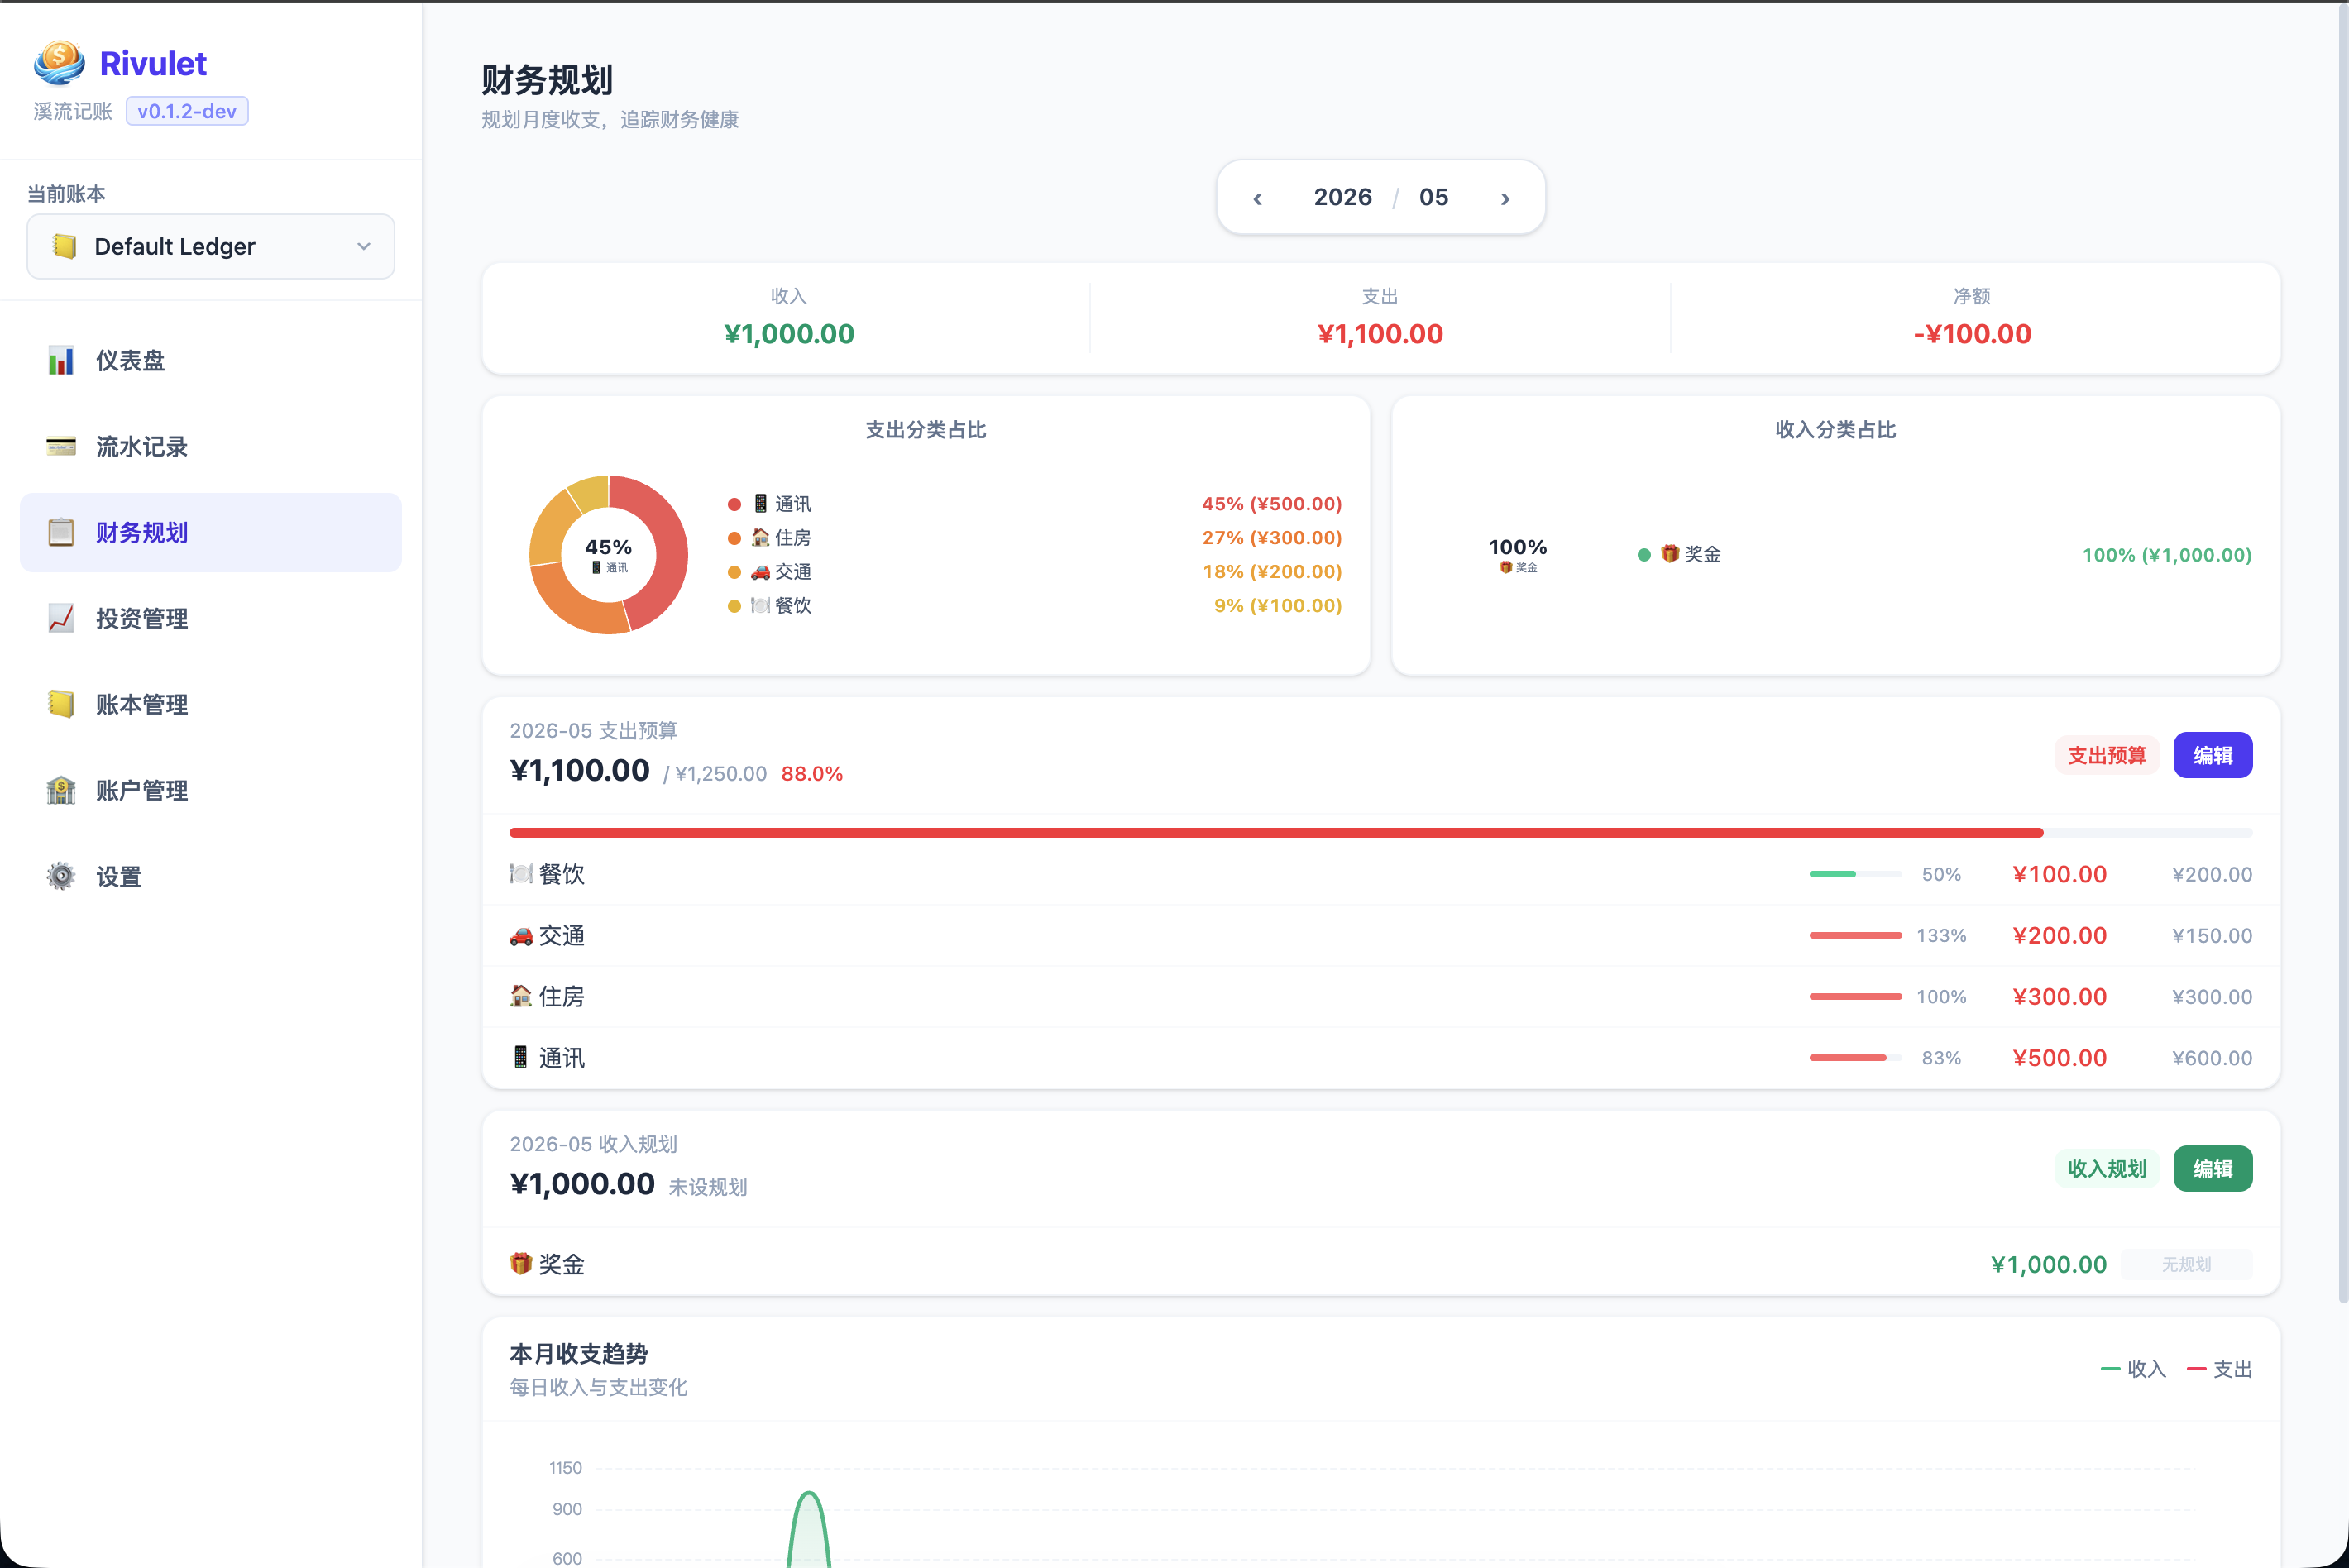
  • 支持财务规划功能,在财务规划界面可以方便的进行每月收入、支出的预算规划,并查看实时的预算执行情况;
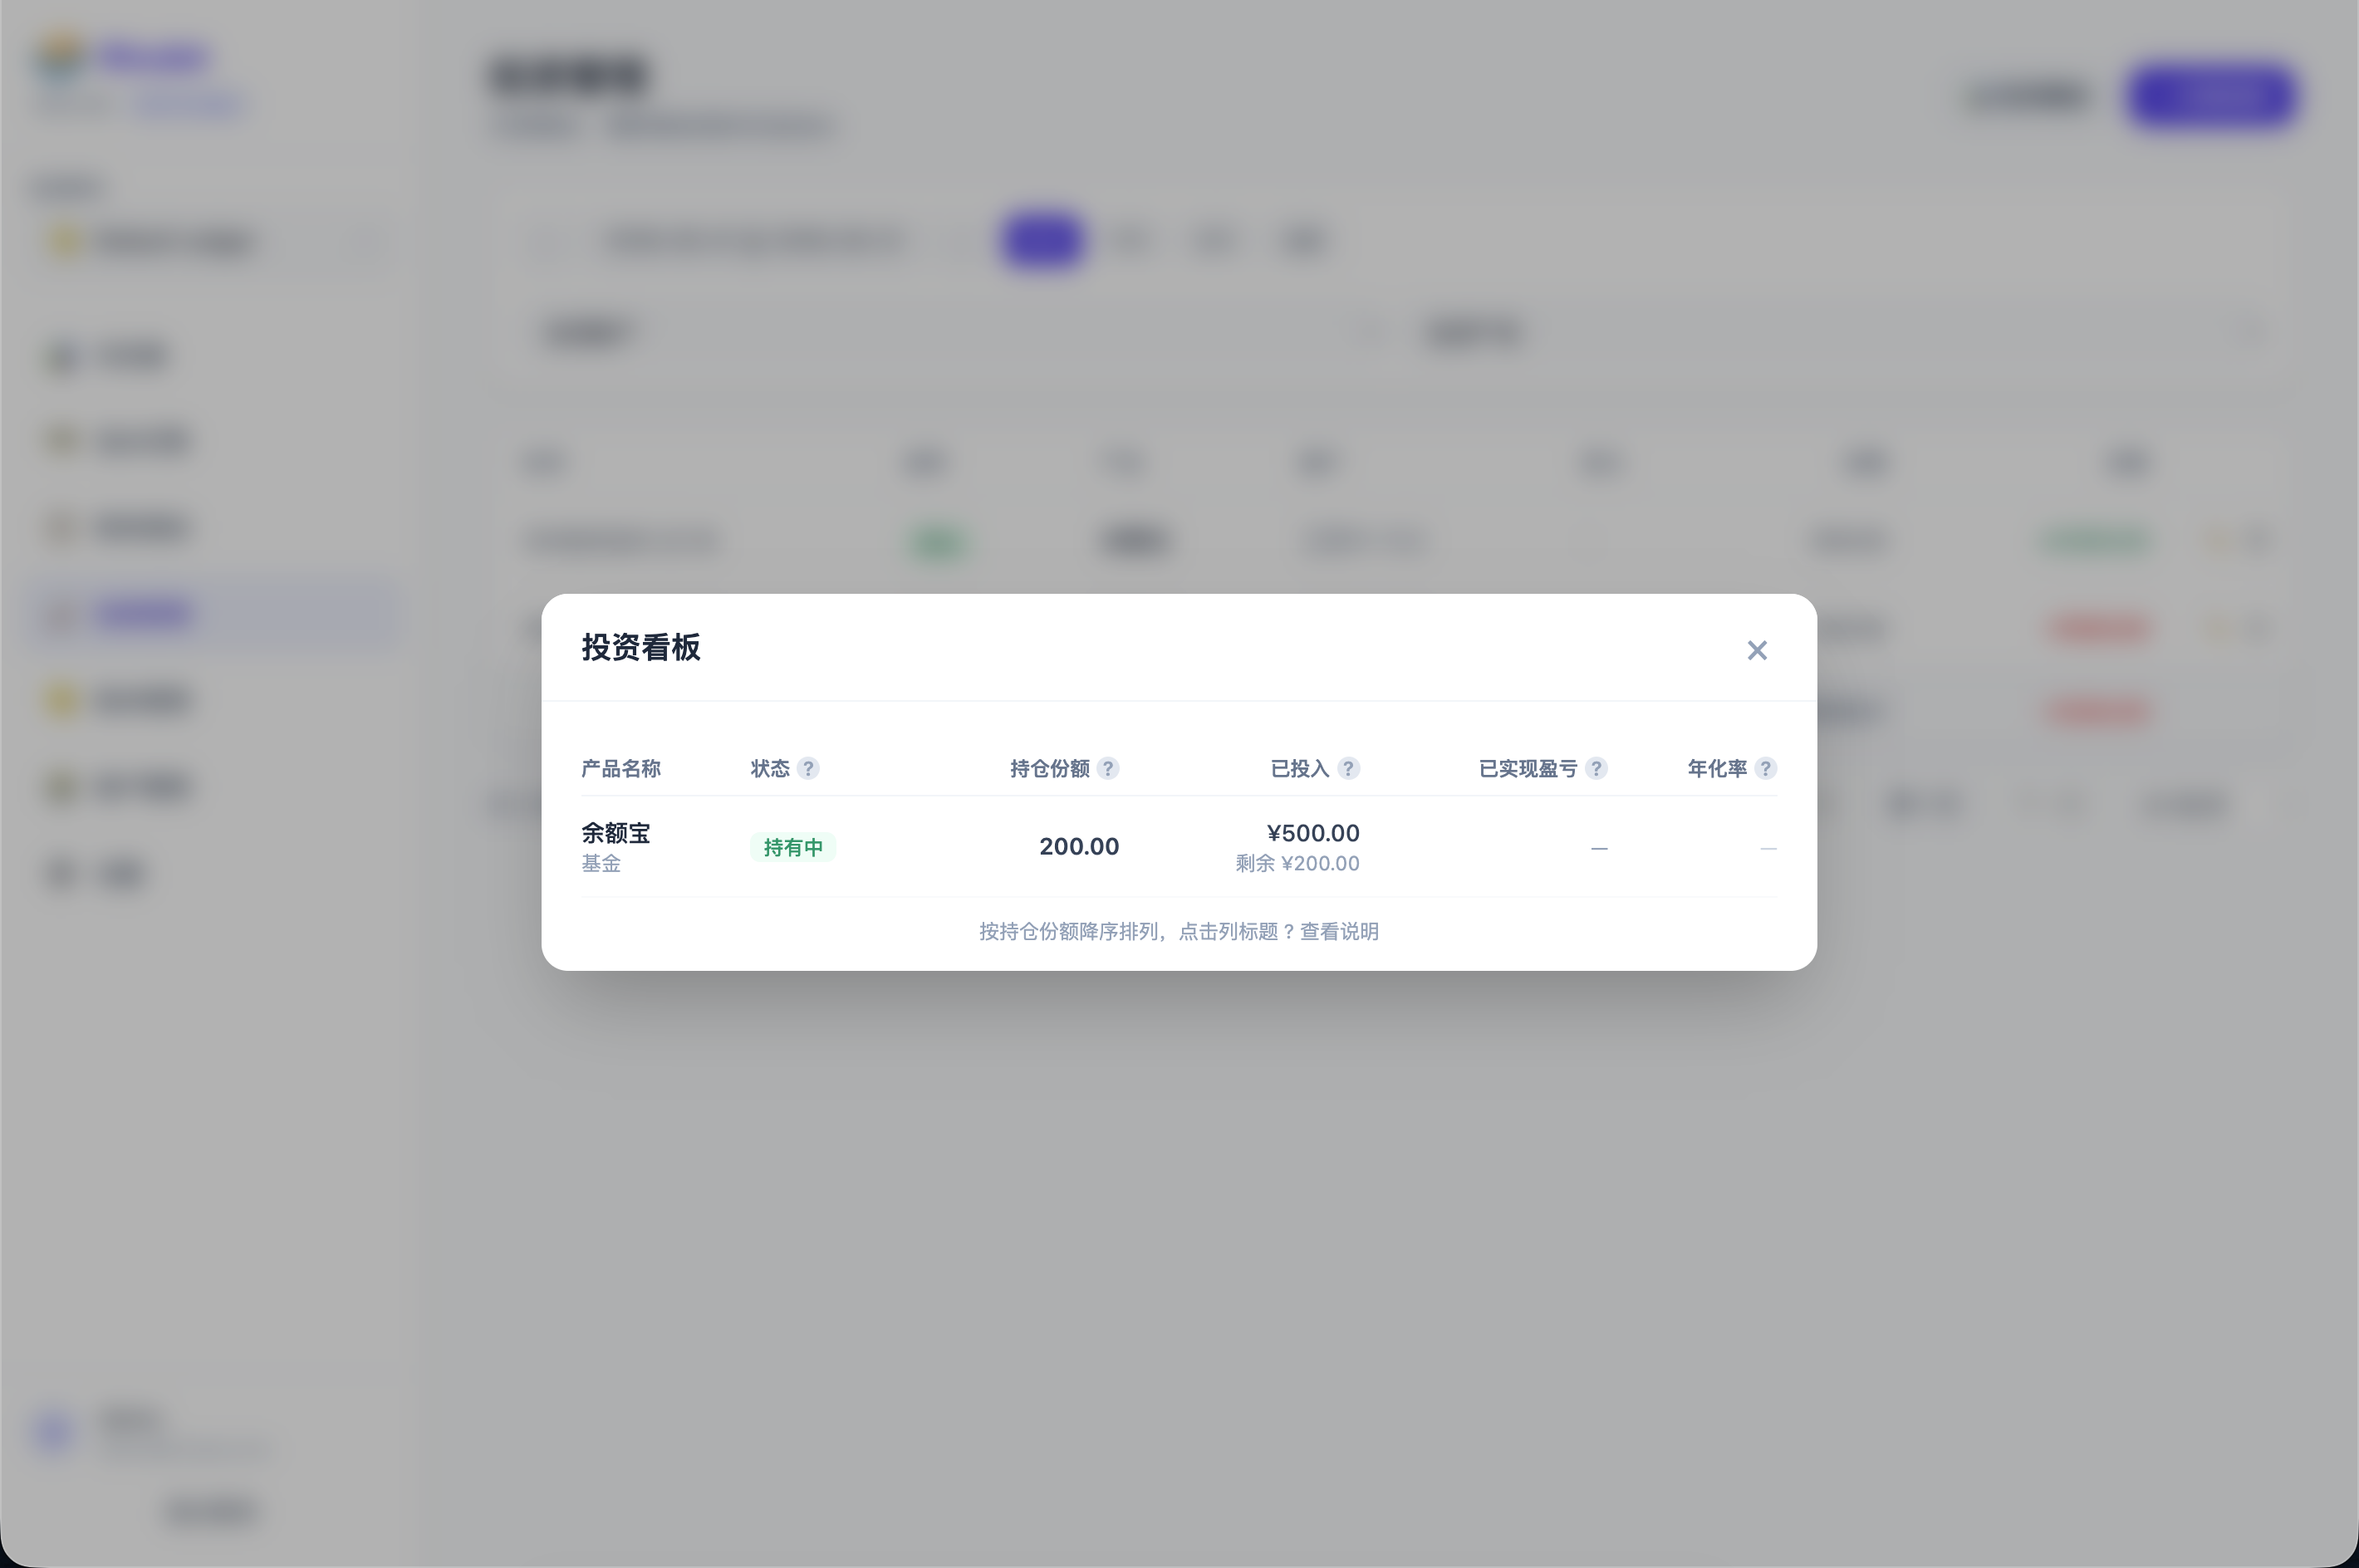
  • 支持投资管理,提供方便的投资买入、卖出、分红记录,投资记录自动生成流水记录,并提供投资盈亏分析;
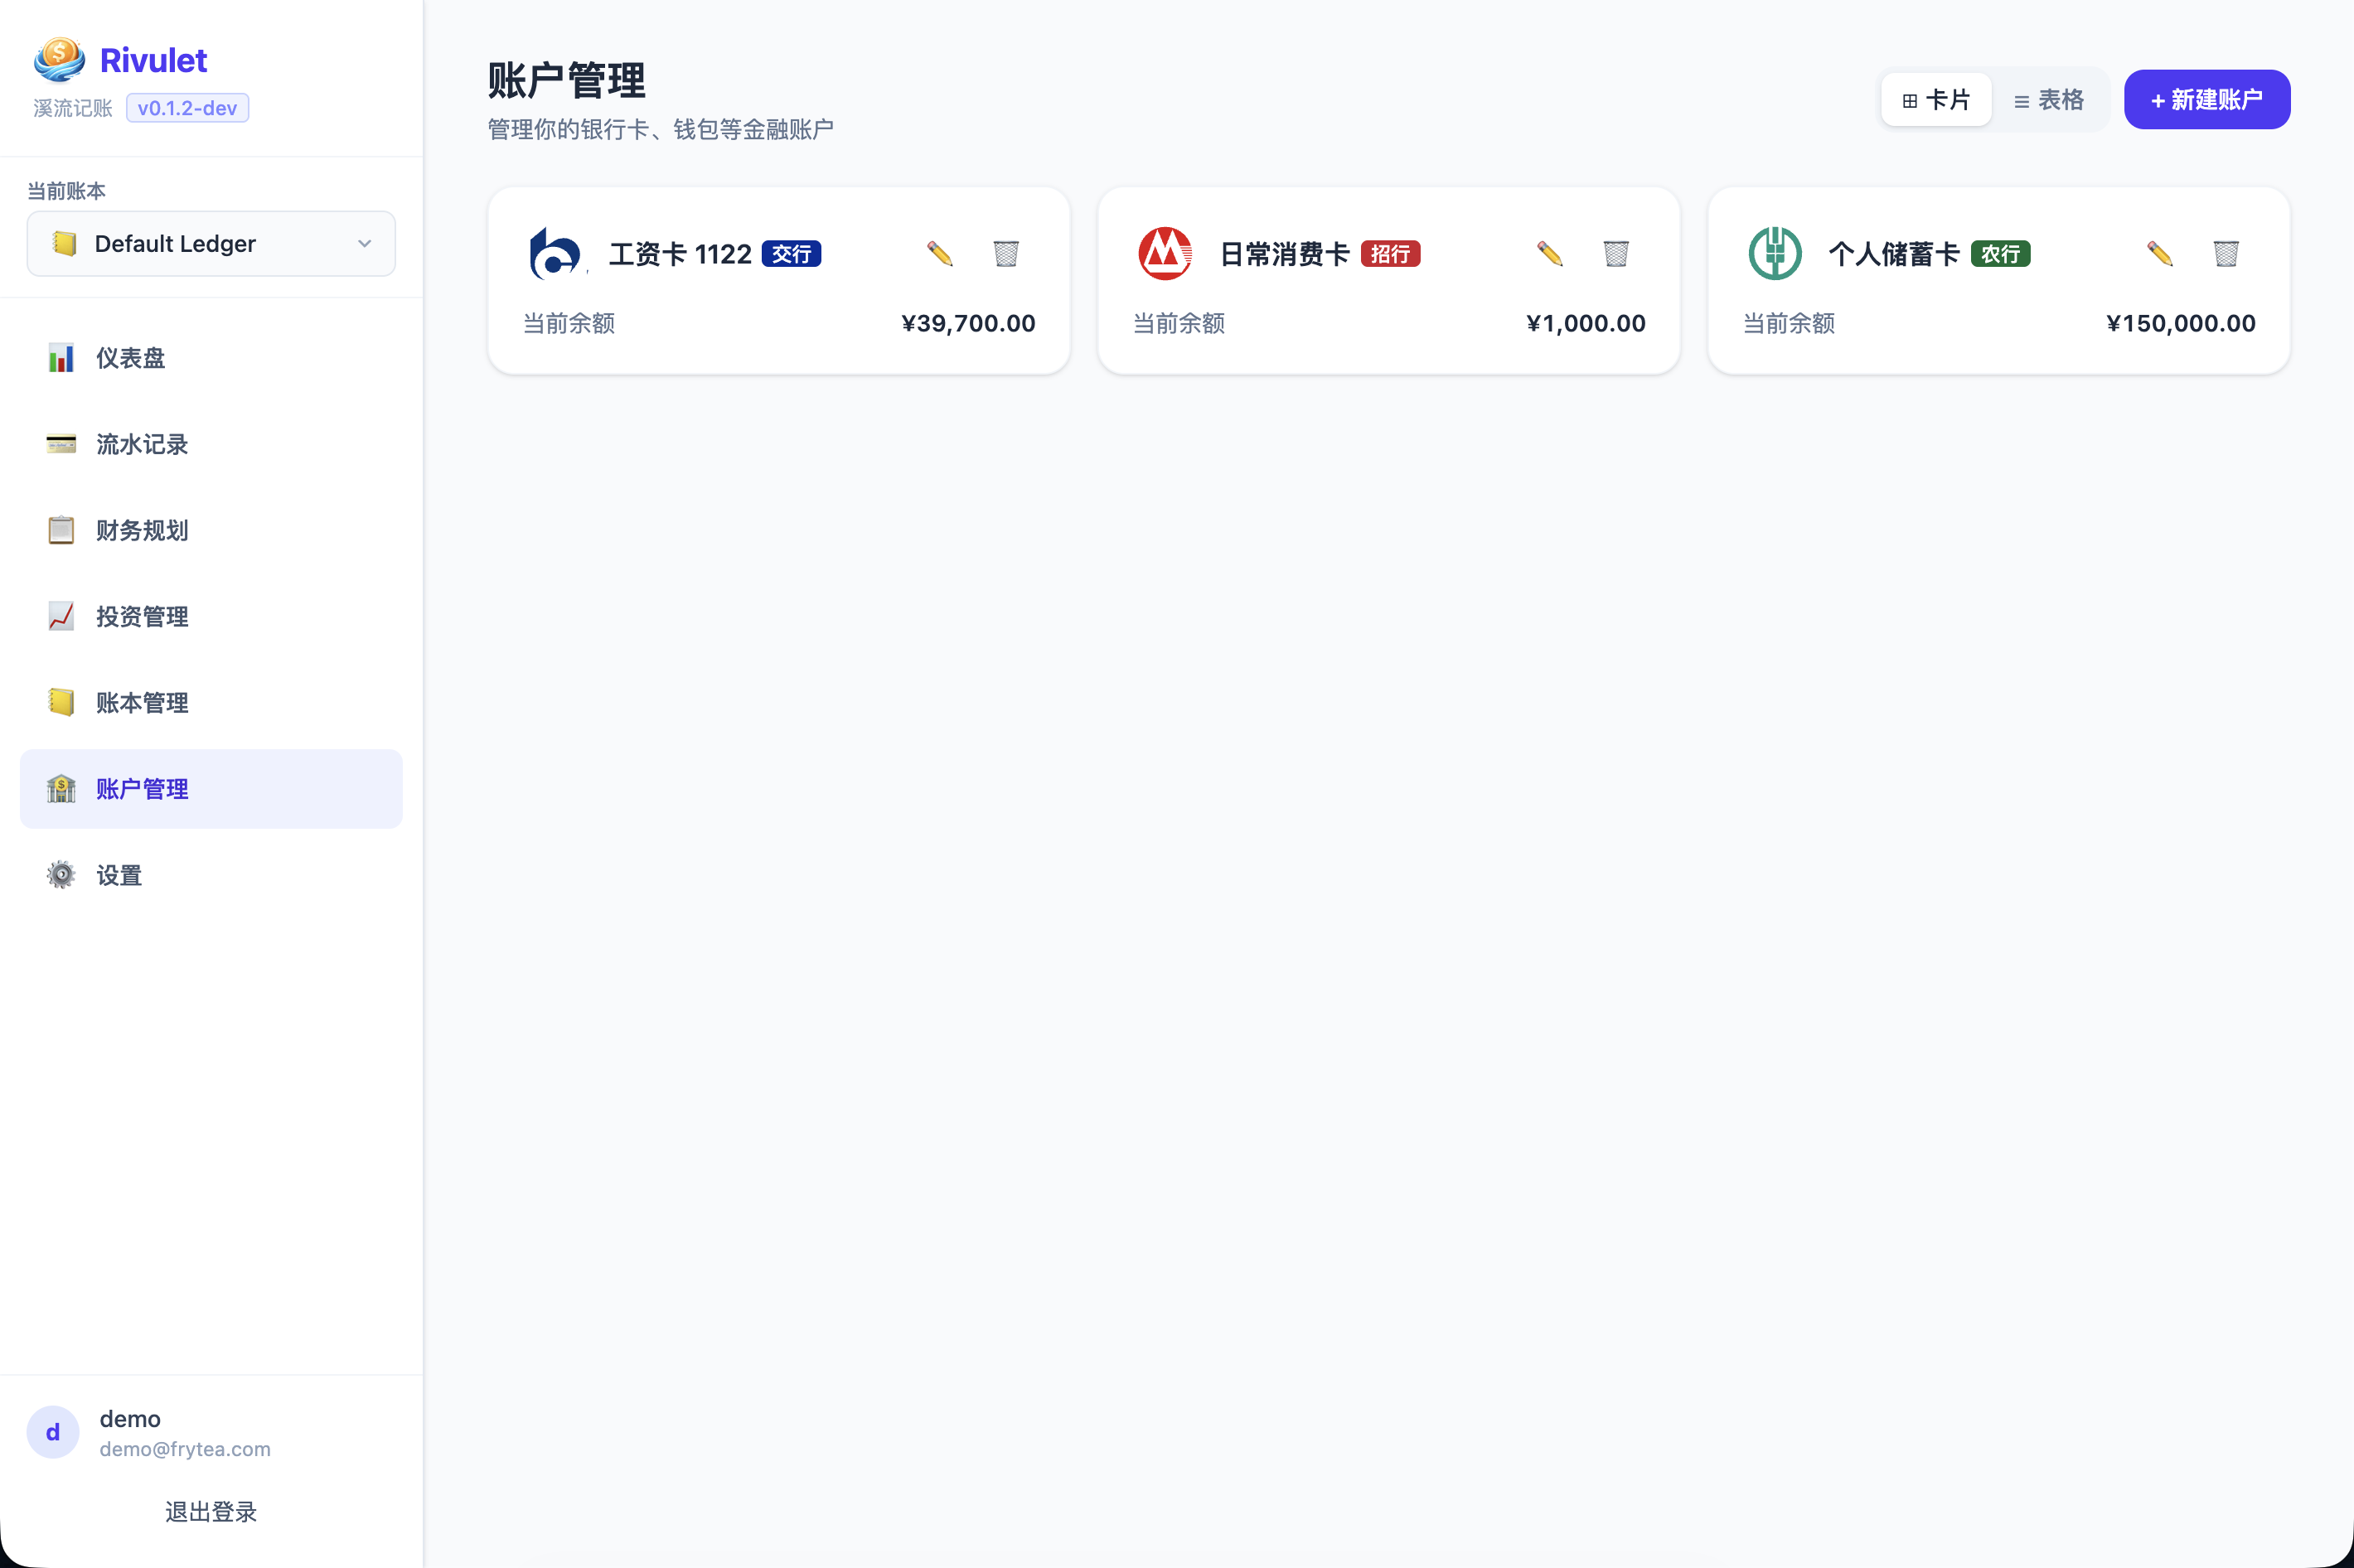
  • 支持账户管理,方便关联自己实际的各个账户;
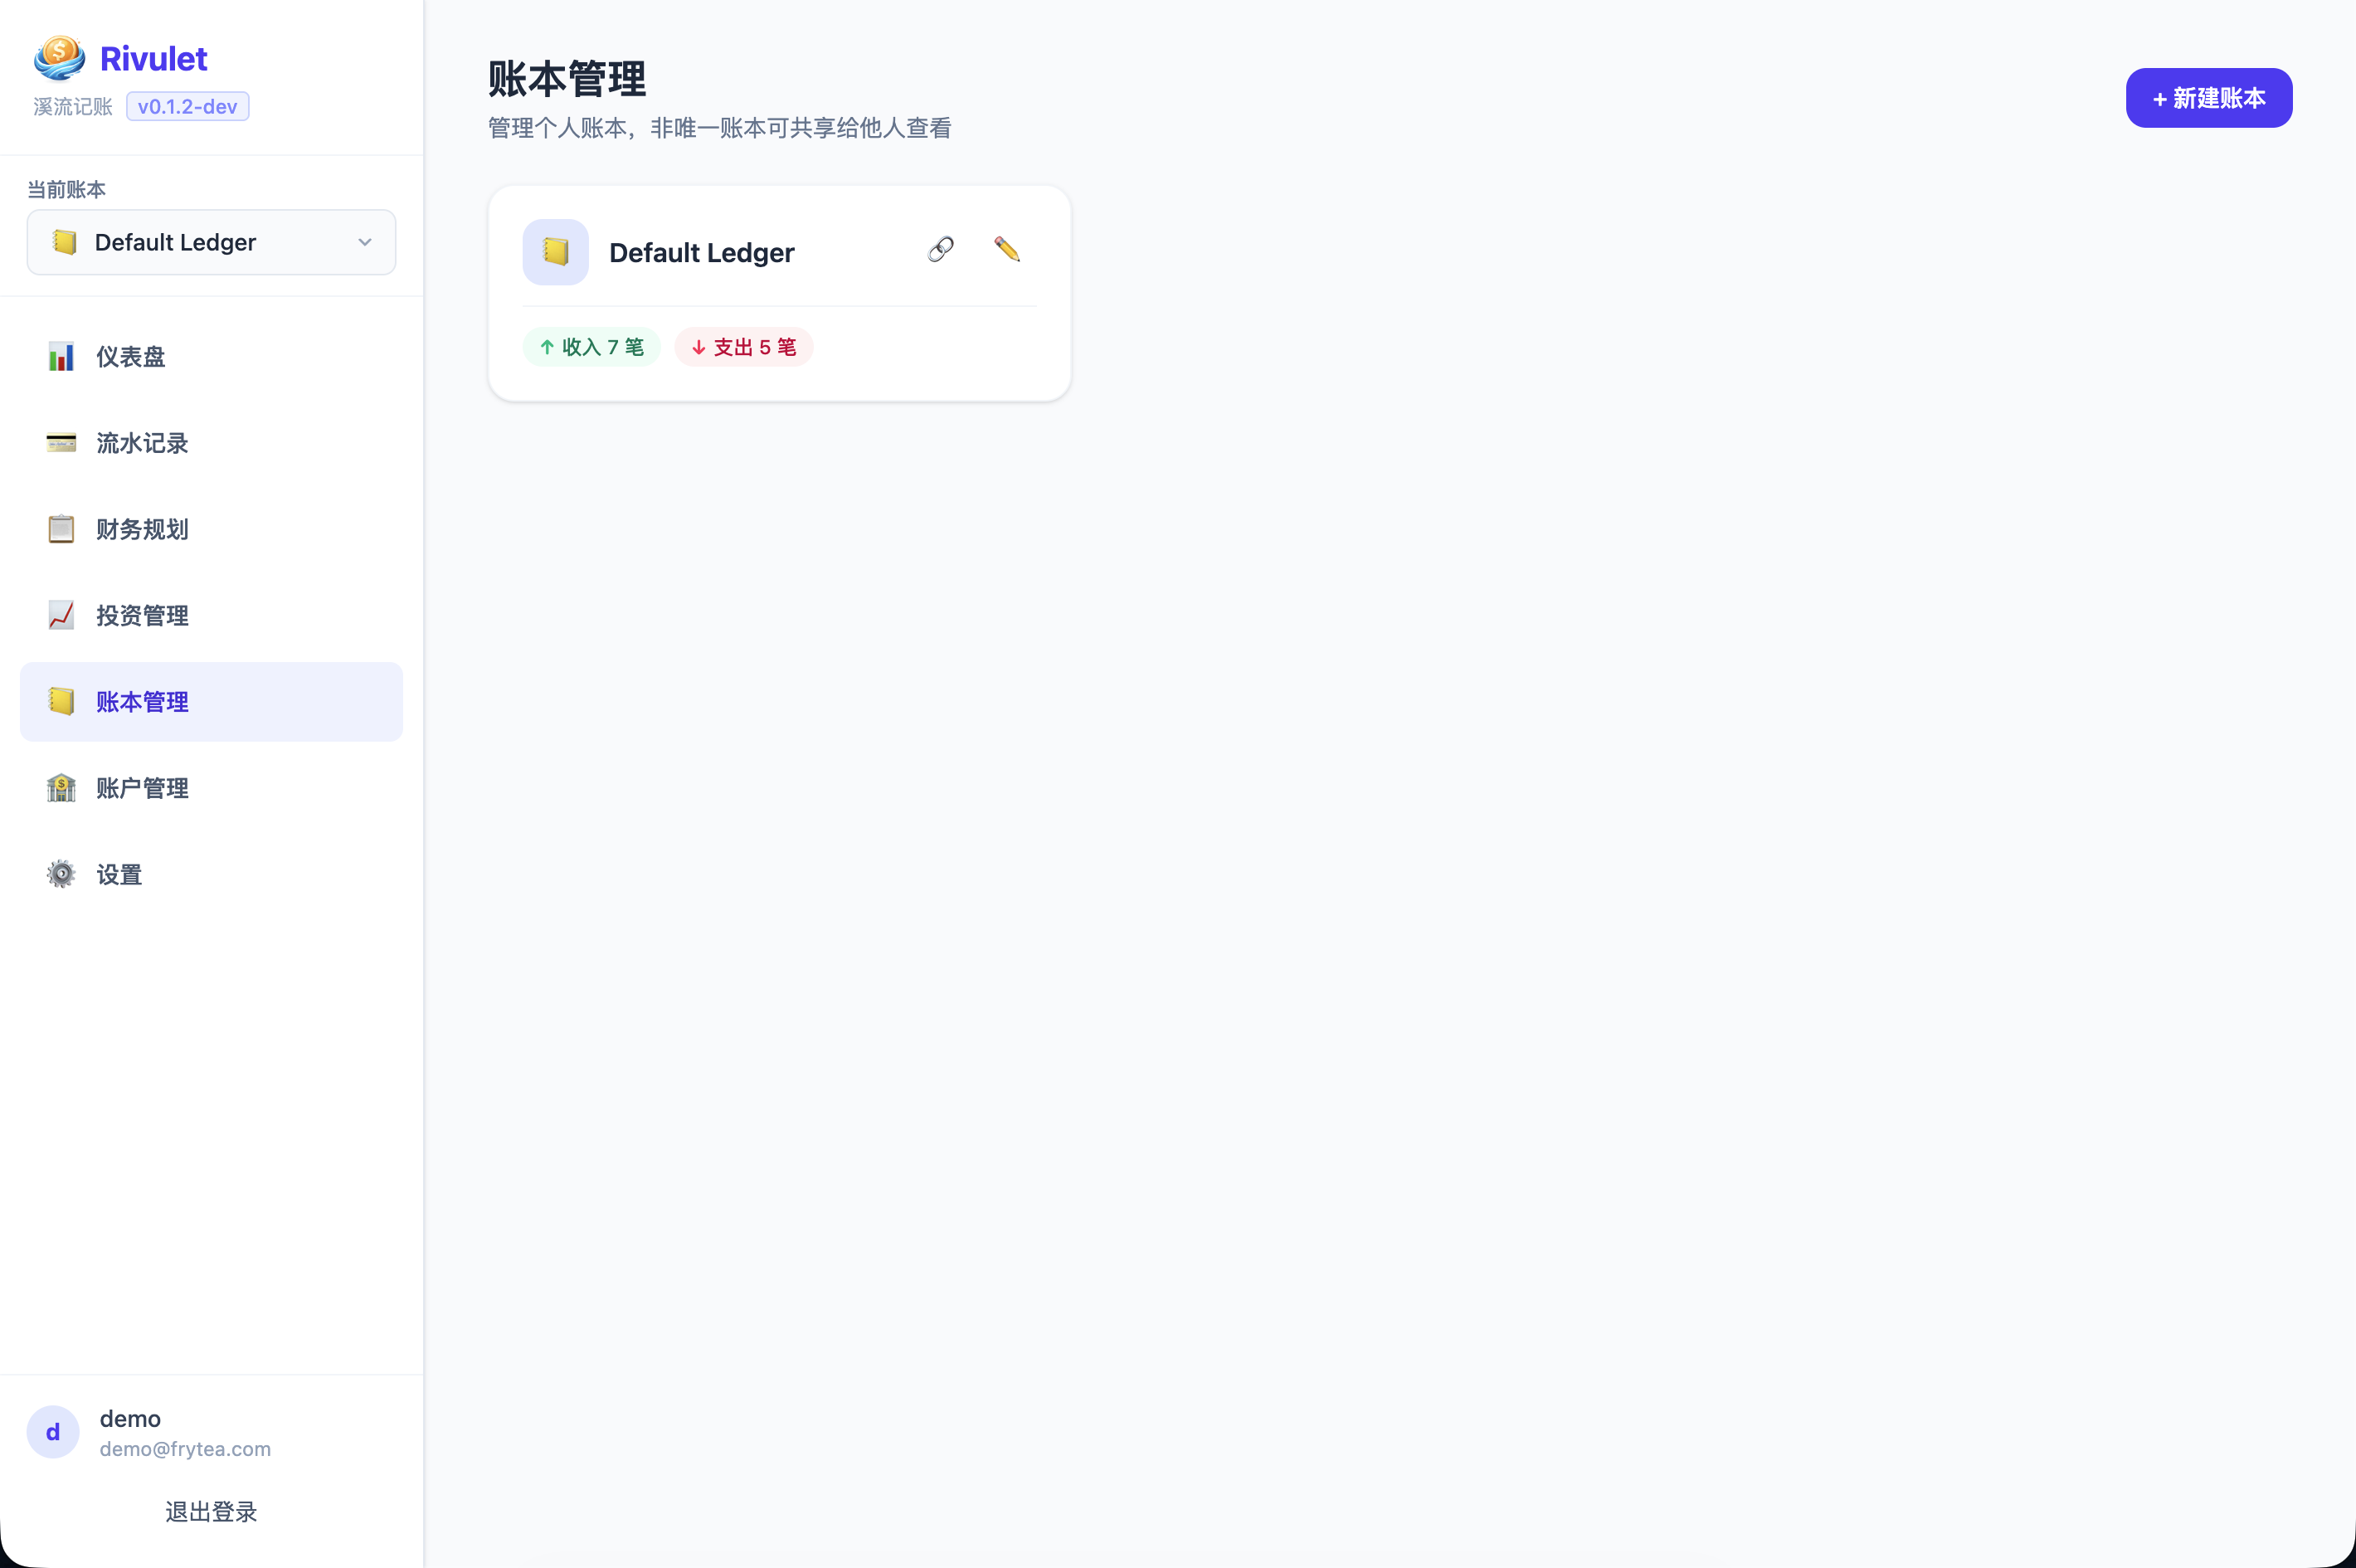
  • 支持多账本,账本间的流水互相隔离,适合不同的使用场景,比如个人账本、家庭账本、公司账本等;支持账本共享。
  • 更多功能陆续开发中。

Rivulet 截图

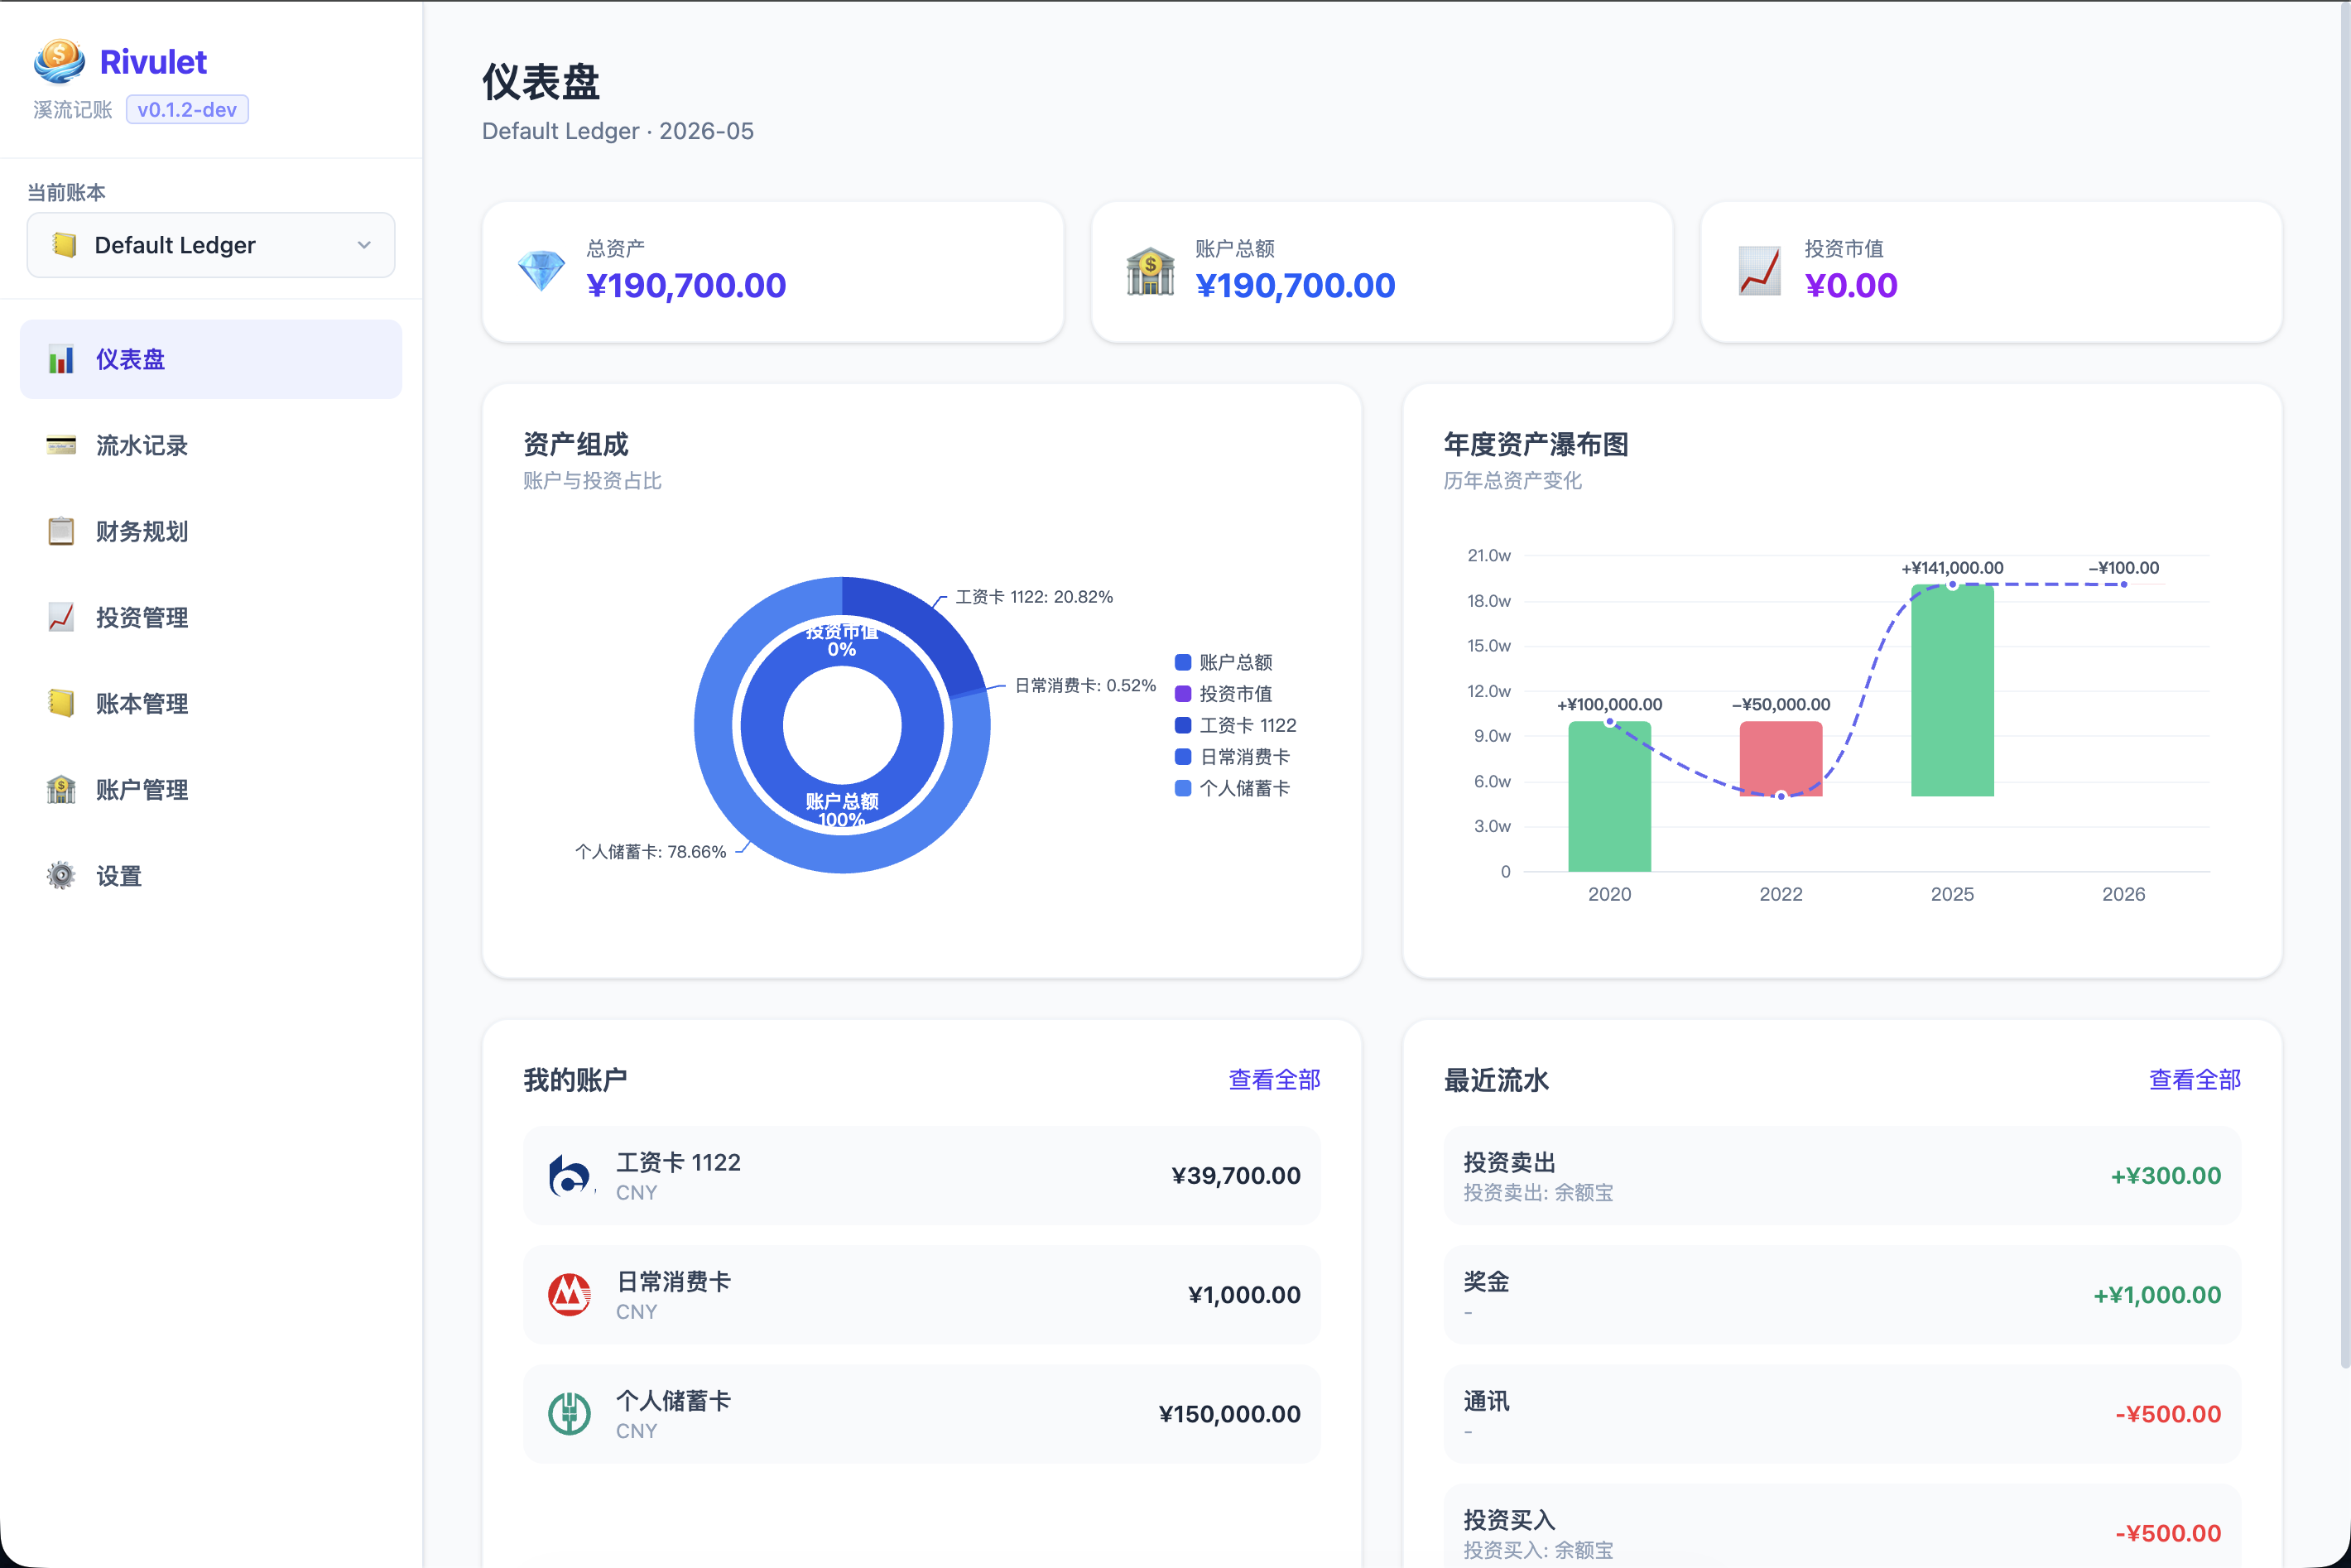
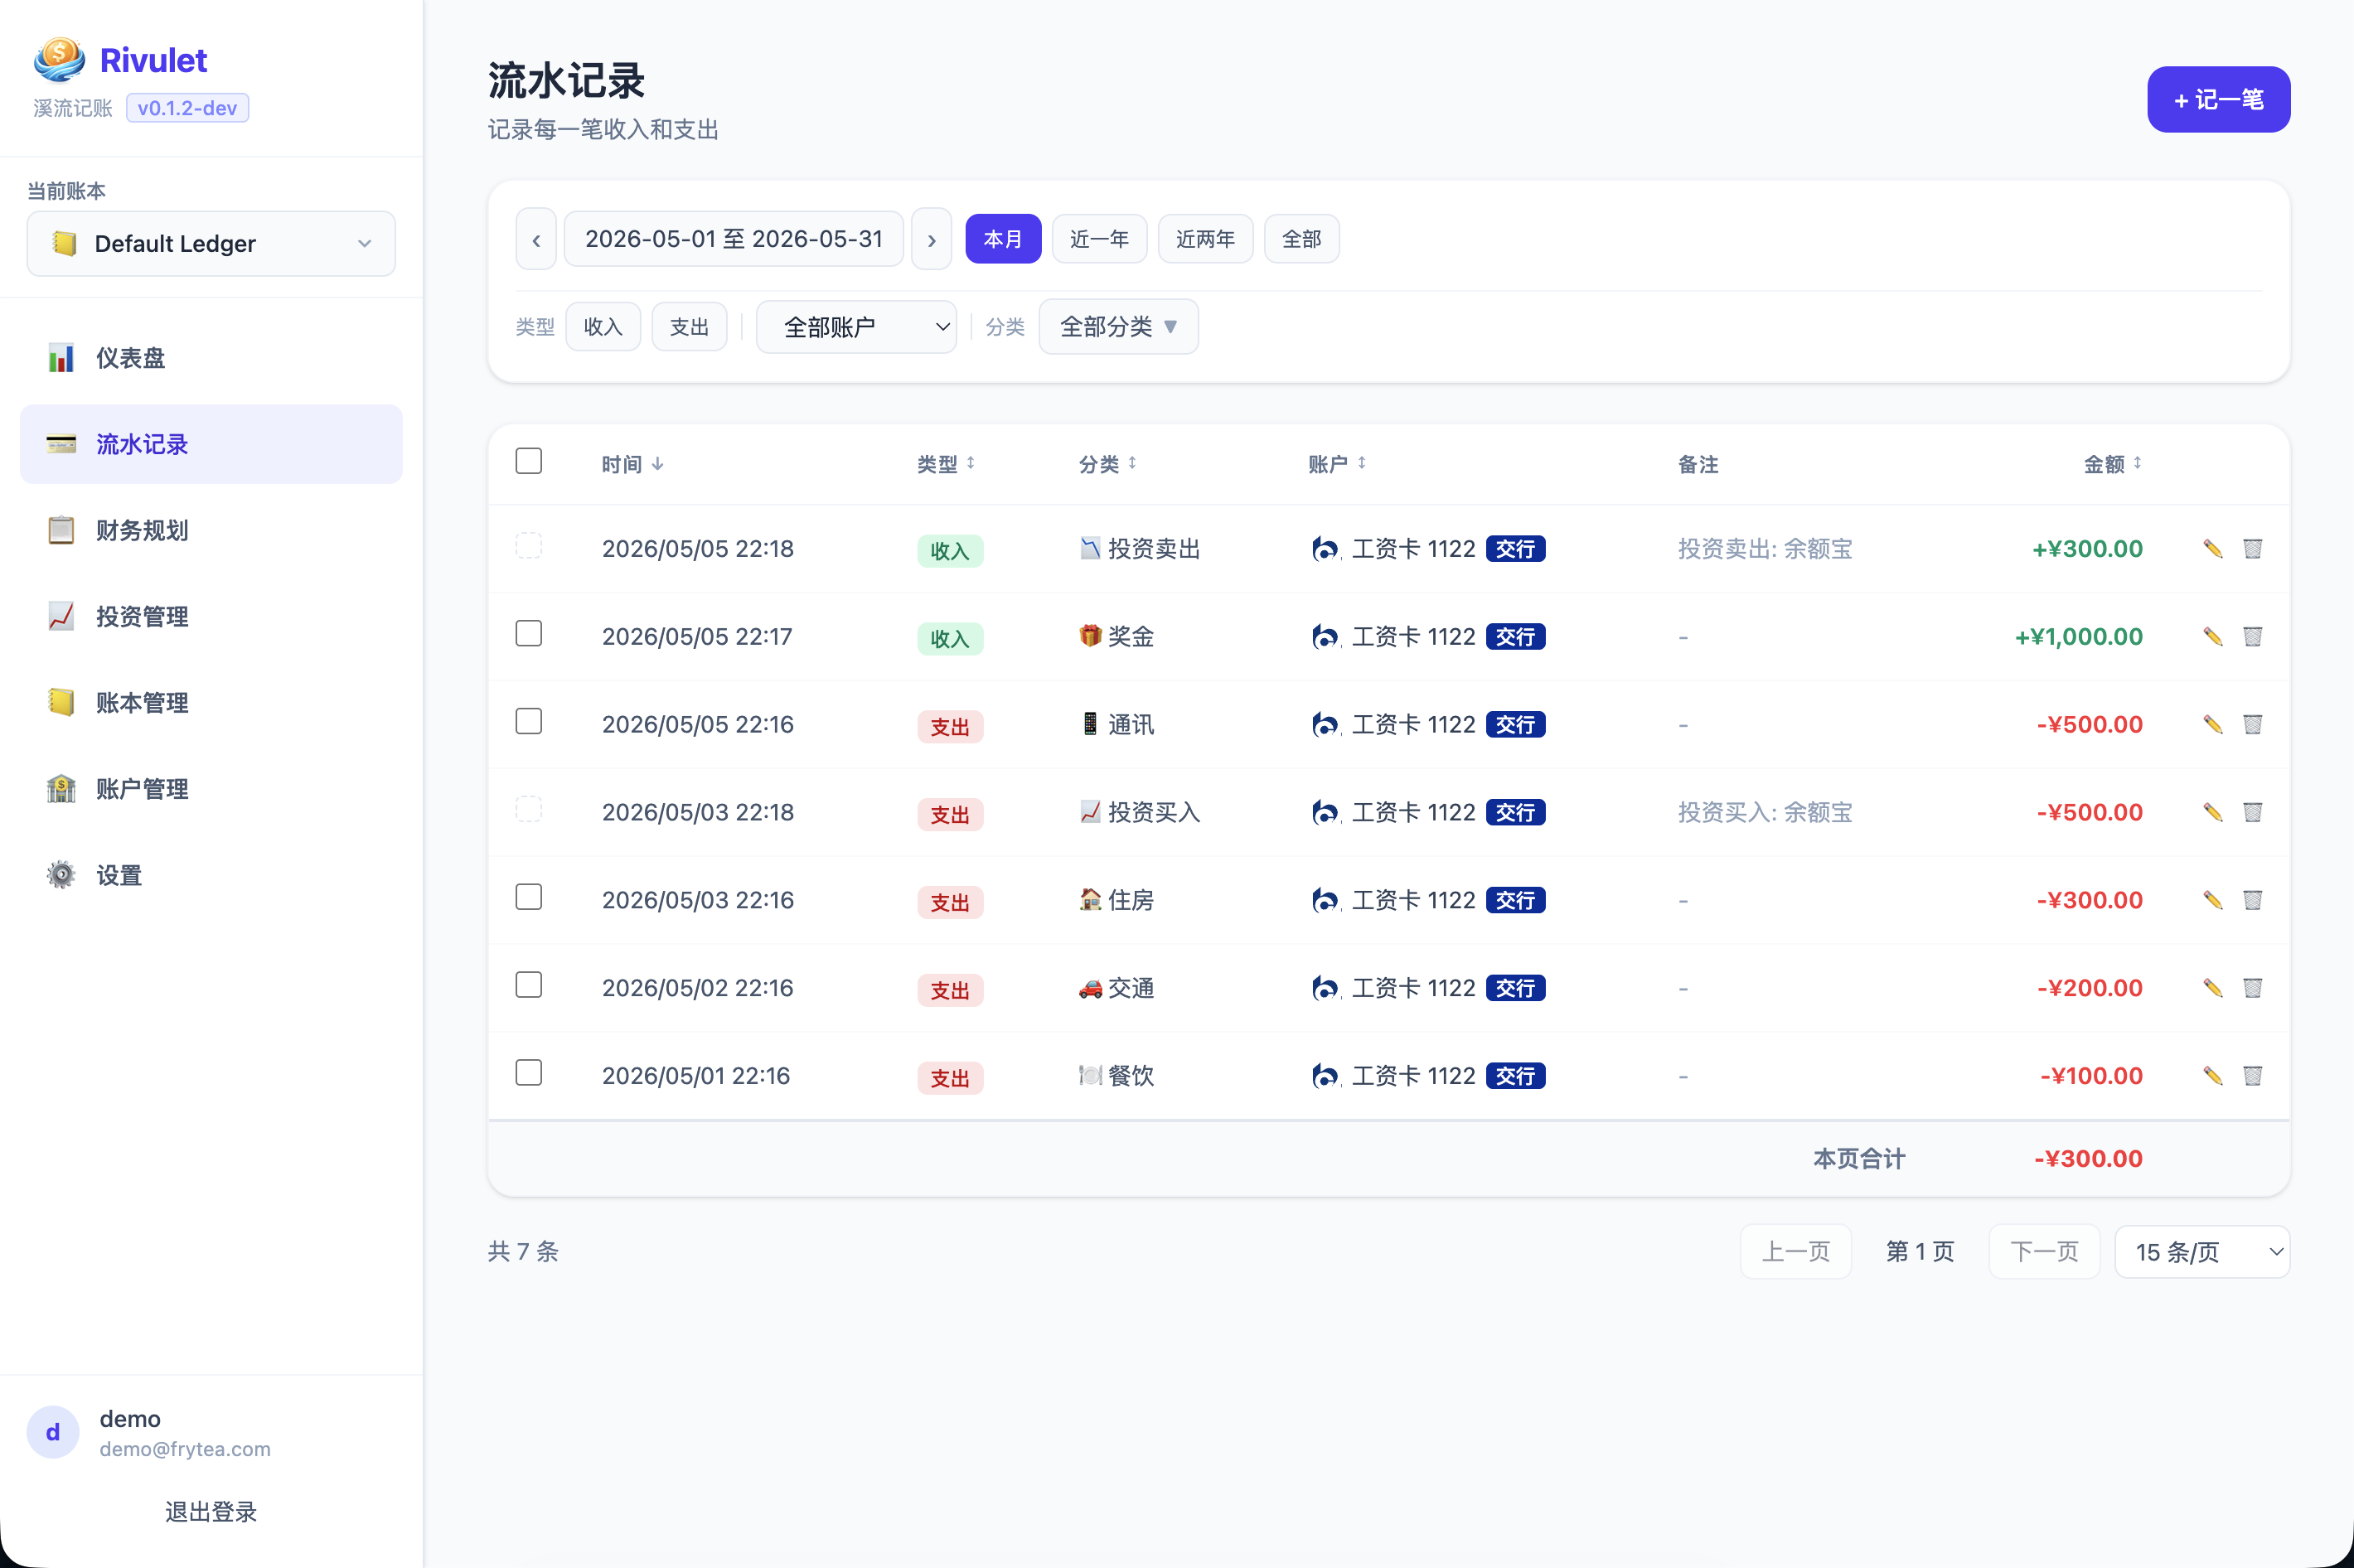
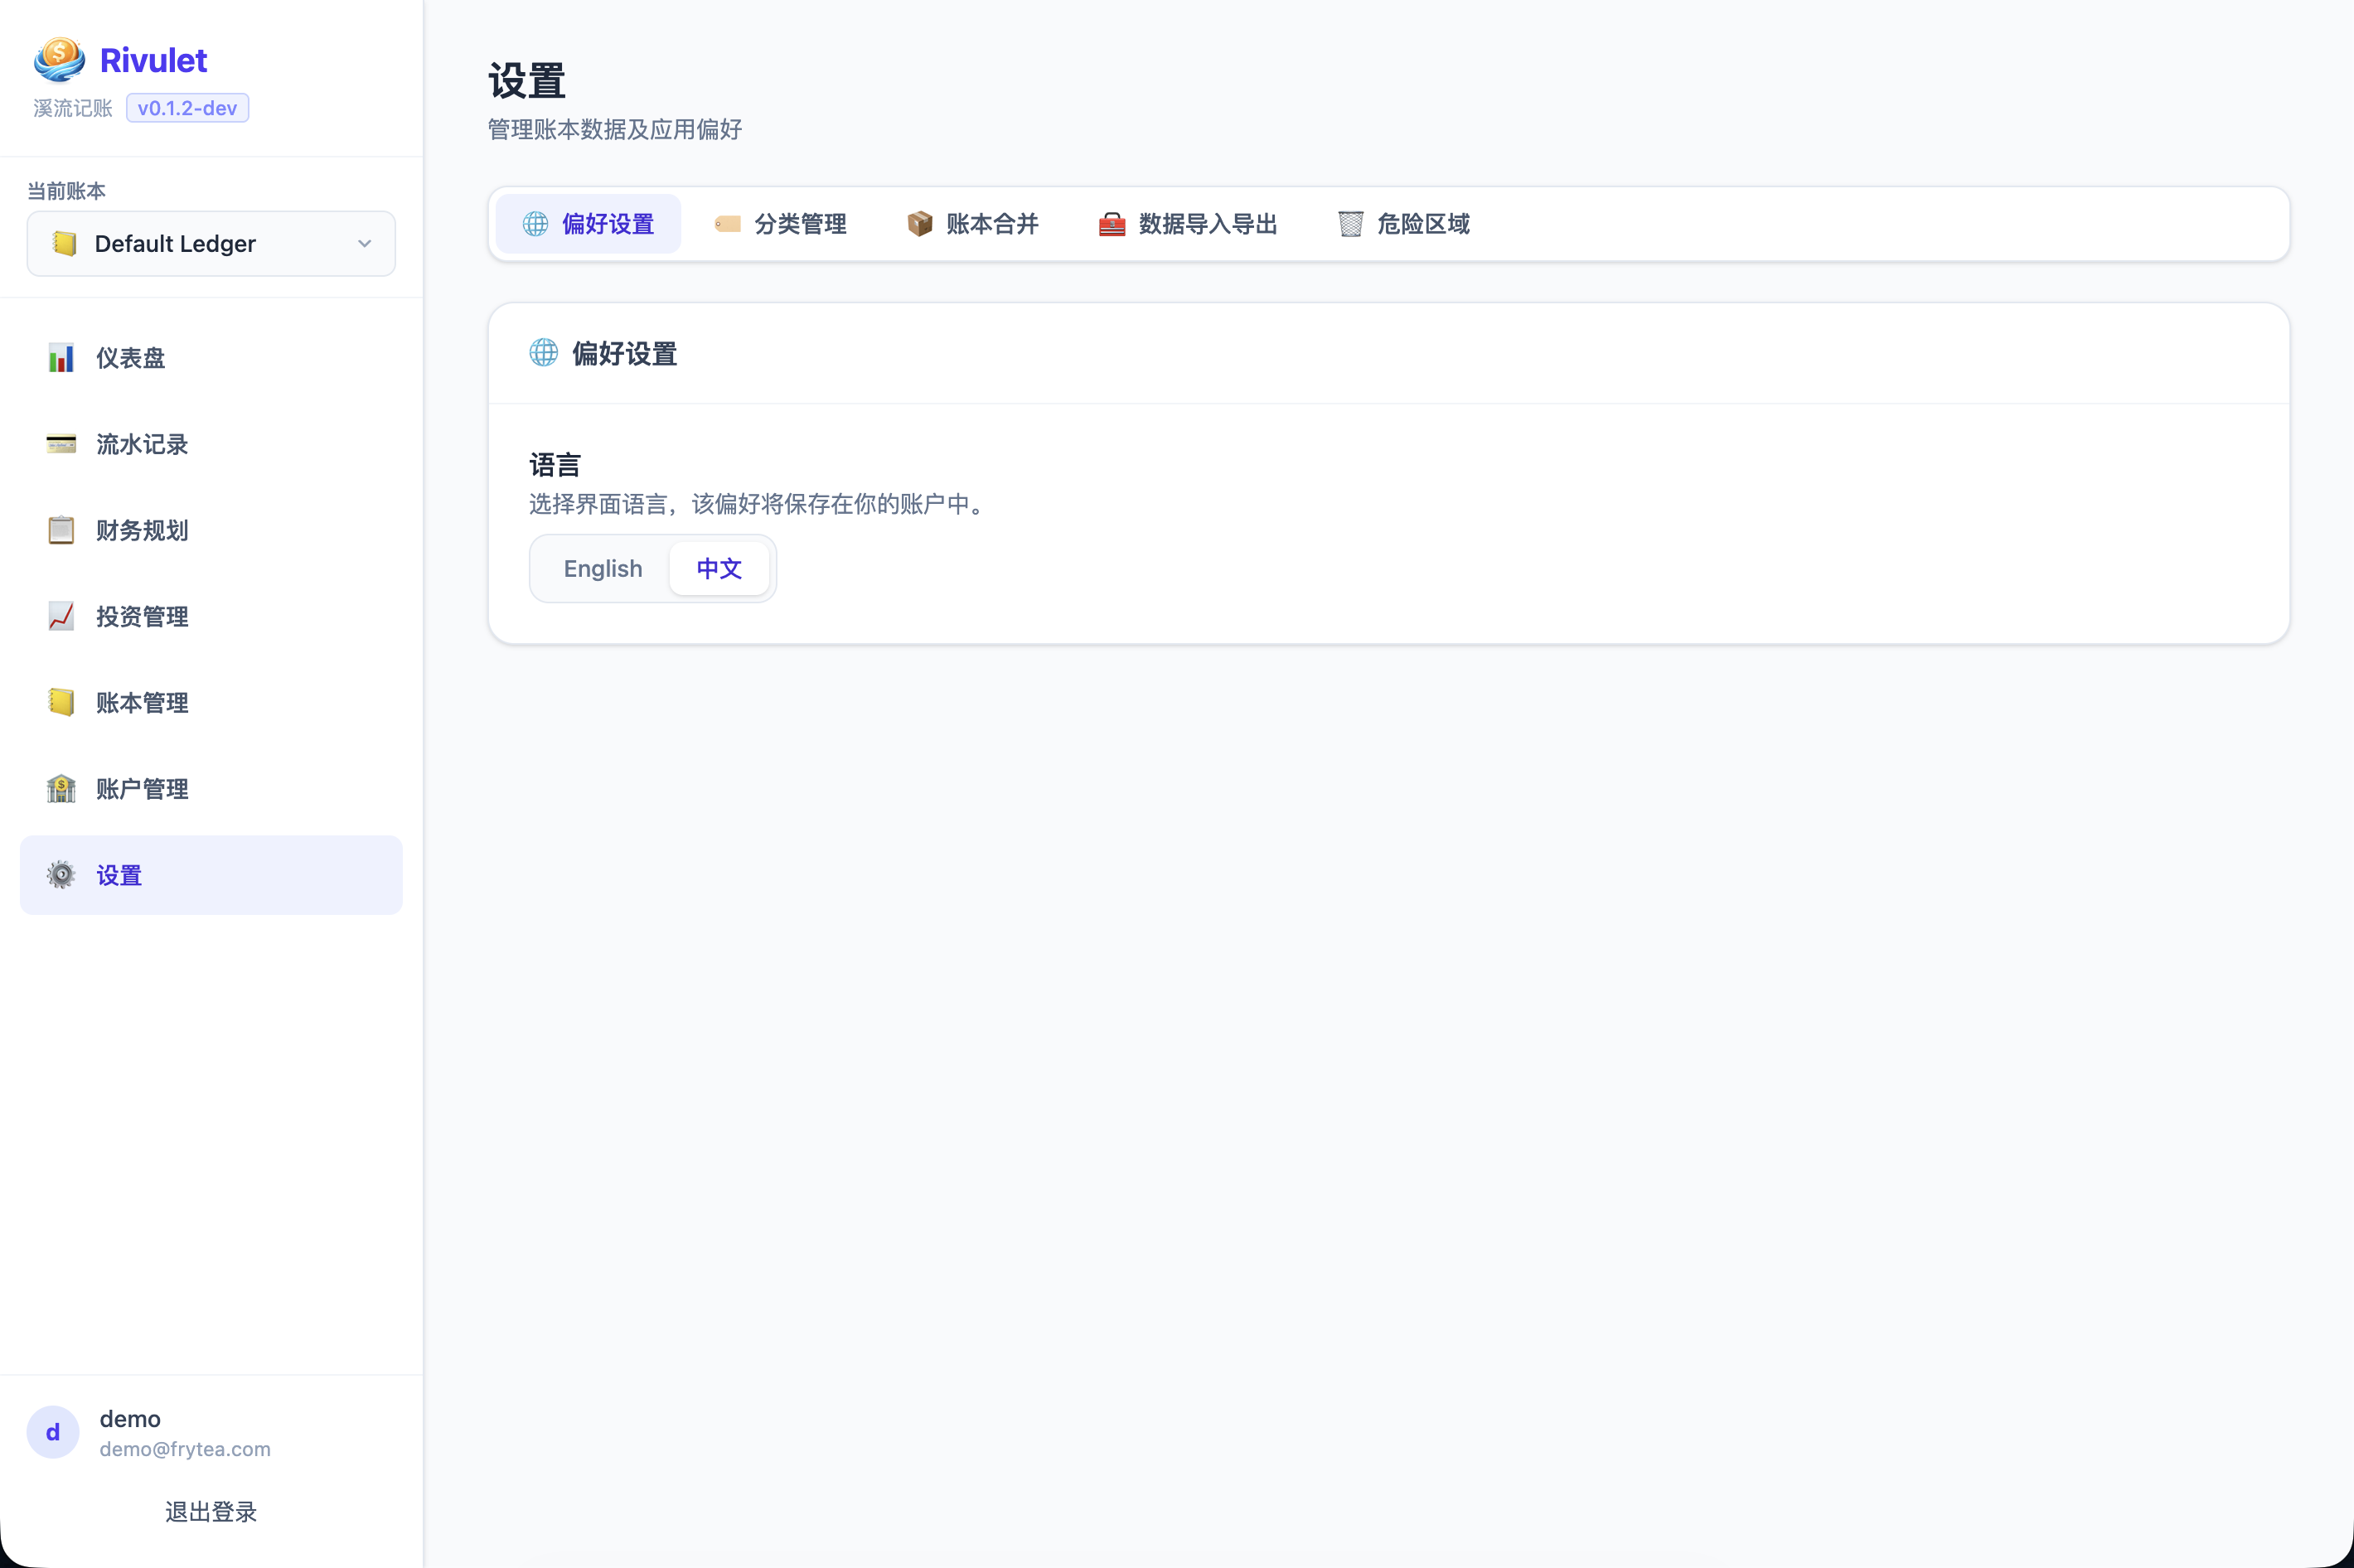
Rivulet dashboard 2026 05 07 22 29 38 Rivulet transactions 2026 05 07 22 29 51 Rivulet budgets 2026 05 07 22 35 12 Rivulet investments 2026 05 07 22 35 26 Rivulet ledgers 2026 05 07 22 35 37 Rivulet accounts 2026 05 07 22 35 45 Rivulet settings 2026 05 07 22 36 01

最后,欢迎大家试用这款软件,如果有任何疑问随时与我交流,也欢迎大家提出宝贵的意见和建议,帮助我一起把这款软件做得更好。

Refs