介绍三种桌面平台下连接 spice 云桌面的方法。
最近需要使用到云桌面办公,但目前仅支持 win 继续阅读
介绍三种桌面平台下连接 spice 云桌面的方法。
最近需要使用到云桌面办公,但目前仅支持 win 继续阅读
最近需要使用到云桌面办公,但目前仅支持 windows 客户端。后经过询问,发现是使用 spice 协议链接,提供地址后,即可使用第三方客户端链接。
MacOS 平台下没有很好的支持 spice 协议的图形化客户端,但是可以使用 remote-viewer 这个工具,也比较好用,下面介绍安装方法:
# jeffreywildman/homebrew-virt-manager 有些问题
# Krish-sysadmin 对它进行了修复,因此首先卸载参与包和地址
brew remove virt-manager
brew remove virt-viewer
brew untap jeffreywildman/homebrew-virt-manager

# 安装工具
brew tap Krish-sysadmin/homebrew-virt-manager
brew install virt-manager virt-viewer

# 如果缺少某些依赖库,安装后重试即可

# 使用
remote-viewer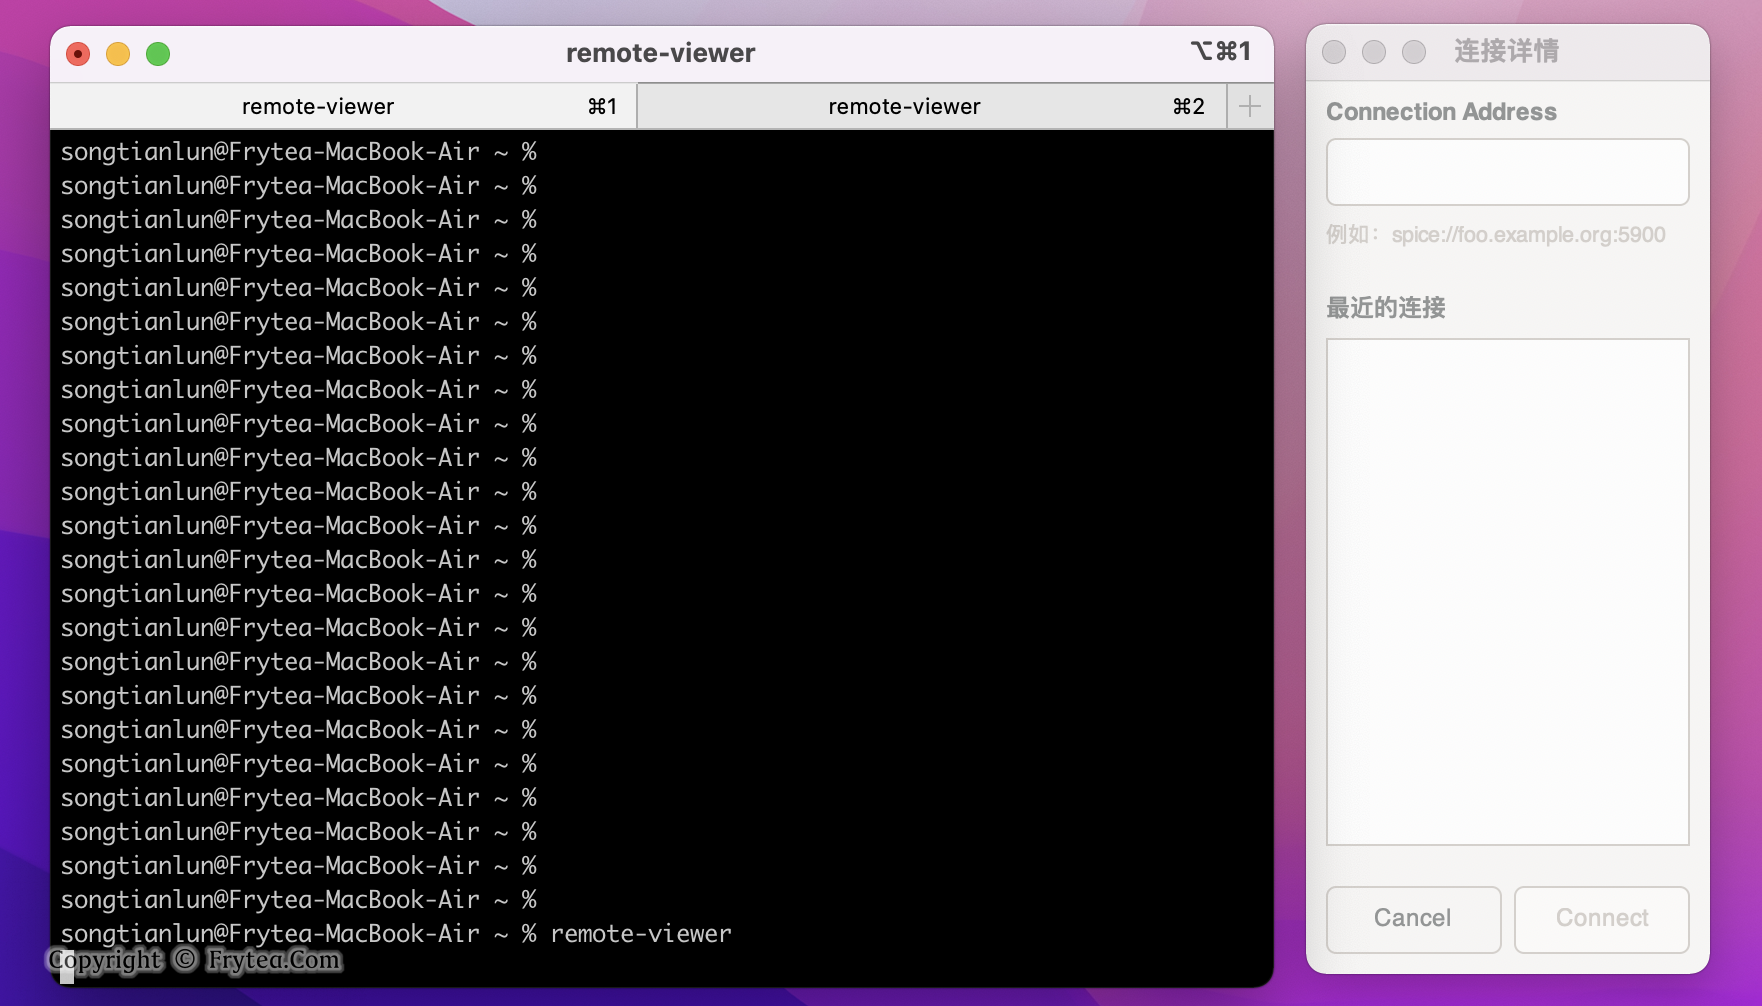
输入 spice 地址链接即可。
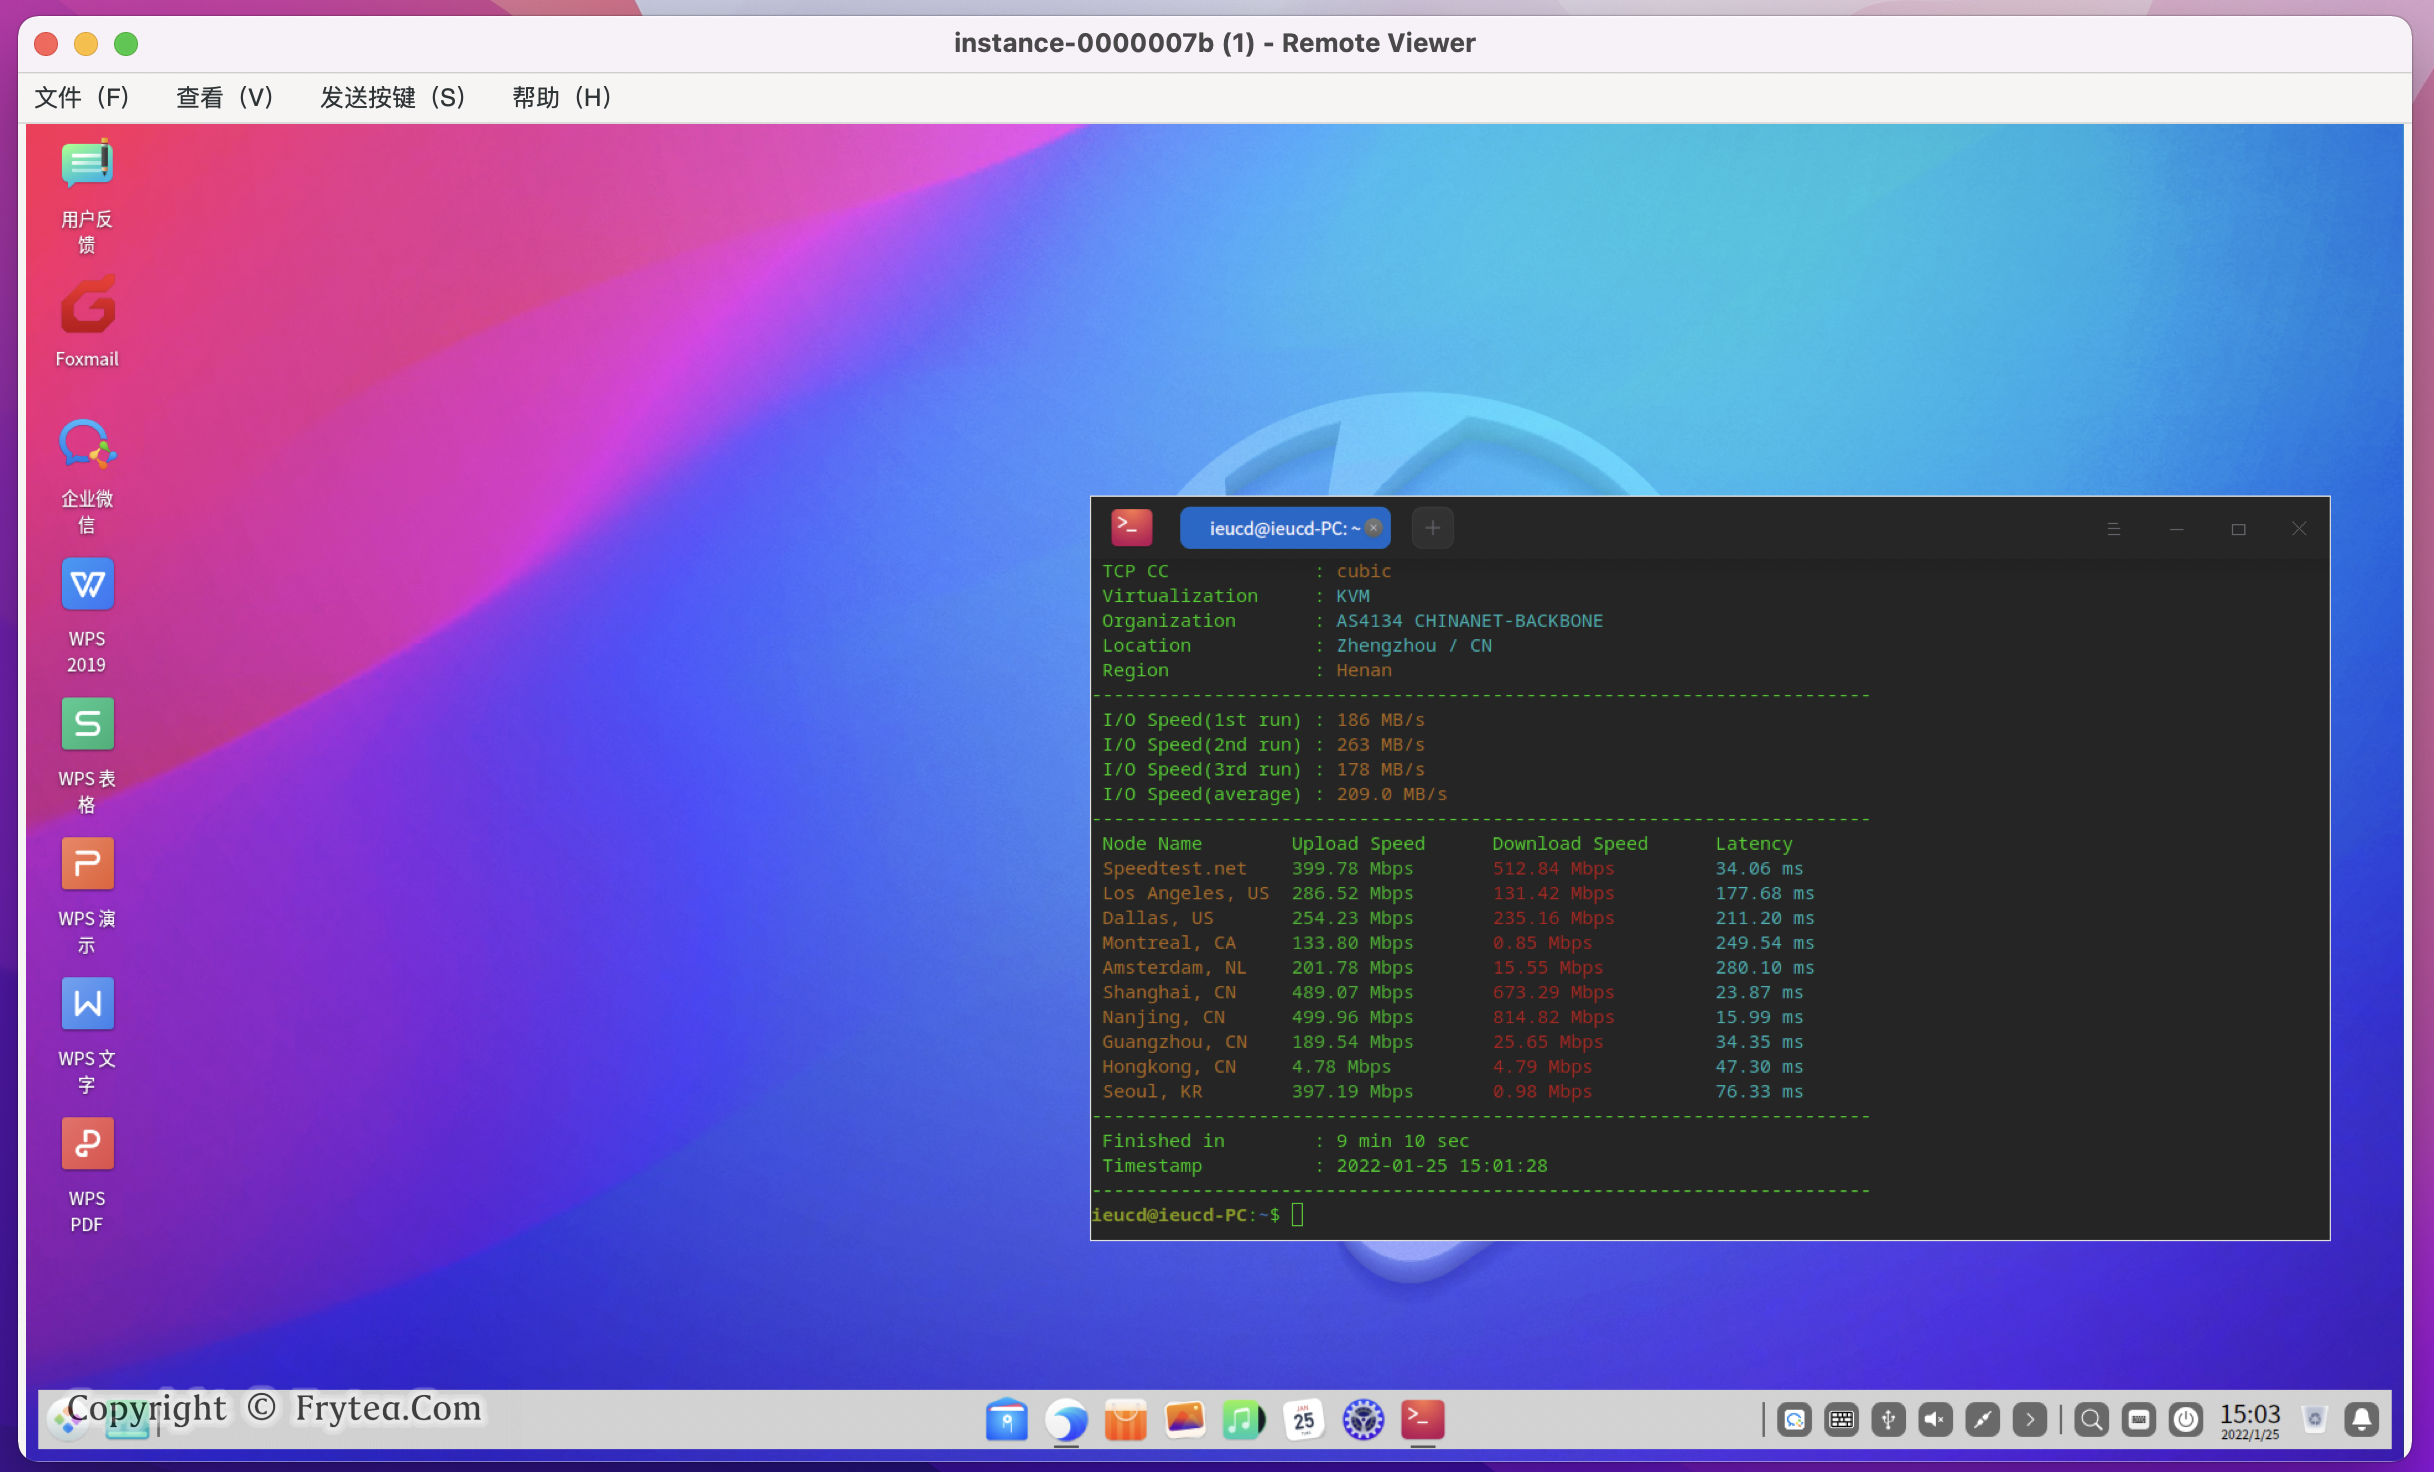
这次探索走了不少弯路,从尝试各种第三方远程桌面客户端,到 remote-viewer 的安装,工具的安装也遇到不少问题,最后在我的 MacBook Air m1 上成功安装,在这里分享方法。
在 Linux 下可以使用 remmina 这款工具,支持 「X2Go RDP SPICE VNC SSH HTTP/HTTPS」。
在 Windows 下则可以使用 virt-mananger 来链接,参考「windows和linux下的spice客户端使用方法」。
至此,Windows、Linux、MacOS 链接 spice 服务的方法介绍完毕。
工作中常需要连接着服务器,下班或暂时离开时会出现一段时间不操作终端,此时就会自动断开。
这本身无伤大雅,重连即可,直到我发现,一些依赖 SSH 提供的服务也会因此受到影响,比如 Pychram 远程开发,会在一段时间后无响应,只能重启 Pychram 解决,很影响效率。
为解决该问题,在网上找到一种配置方法,亲测一夜 (10h+) 不会再断开,在此分享:
众所周知,SSH 是用于与远程服务器建立加密通信通道的,因此配置涉及服务端和客户端:
/etc/ssh/sshd_config-#ClientAliveInterval 0 #服务器向客户端发送请求消息的时间间隔,默认为0,不发送
-#ClientAliveCountMax 3 #服务器发出求后客户端没有响应的最大次数,超过后将自动断开。
+ClientAliveInterval 60 #每60秒发送一个KeepAlive请求
+ClientAliveCountMax 15 #总时间为:15*60 ,15分钟没有操作,终端断开。
# 以下任意命令重启 sshd 服务
service sshd reload
service sshd restart
systemctl sshd restart~/.ssh/config# 修改 ~/.ssh/config 对当前用户生效
# 这样配置通配所有服务端
Host *
ServerAliveInterval 60
# 指定IP配置
Host *hostname.com #指定IP
ServerAliveInterval 60
# 或是全局配置(对所有用户生效)
vim /etc/ssh/sshd_config
+ ServerAliveInterval 60先说结论:python不允许程序员选择采用传值还是传引用。
在函数传值,或函数内部函数引用外部变量时,基本符合这个逻辑,比如:
def test_dect_out():
    lvs = {}
    num1 = 3

    def lan():
        lvs['sss'] = 4
        num1 = 5
        return lvs, num1

    print(lvs, num1)
    print(lan())
    print(lvs, num1)

{} 3
({'sss': 4}, 5)
{'sss': 4} 3当 python 需要调用 C 程序,或是进行文件、网络操作时,需要对二进制结构化字节流进行处理,此时需要使用到 struct 这个模块提供的方法。
详细方法可以查看 官方教程,这里以 perl 的 pack 作为对比,使用 python 实现类似 perl 数据打包的效果。
在 perl 的 pack 方法中,提供了一种 Z* 的写法,可以总是保证最后有一位空填充,在 python 中则可以这样实现:
# 类比 perl 的 pack "VVVVZ*", $max, 0, 0, 0, $user;
fmt = "<4lx" + str(len(user) + 1) + "s"  # 类比 perl Z*,总是保证最后有一位空填充
bindata = struct.pack(fmt, maxn, 0, 0, 0, bytes(user, encoding="utf8"))
# 小端序,4个 long (32位整) 后面跟 填充字节 ,然后再拼 字符长度 +1 个 s(字节串)
最后打印出来的效果是这样:
b'tasklist\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00dev\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00'如果直接使用 .format 或是字符拼接 + `.ljust(256, '\000') 之类的方法在后面强行补 也是可以实现类似的效果,但是打印出来还是字符对象,不是我希望的字节流对象,而且很繁琐,不专业:
'tasklist dev '大概就是这样,像是中间塞了一堆空格。建议数据打包还是使用 struct.pack 来进行。
基本实现需求。
本文内容为 Linux 系统通用,各个语言实现可能稍有不同,但原理相同。
当多个进程或多个程序都想要修同一个文件的时候,如果不加控制,多进程或多程序将可能导致文件更新的丢失。
例如进程1和进程2都要写入数据到a.txt中,进程1获取到了文件句柄,进程2也获取到了文件句柄,然后进程1写入一段数据,进程2写入一段数据,进程1关闭文件句柄,会将数据flush到文件中,进程2也关闭文件句柄,也将flush到文件中,于是进程1的数据被进程2保存的数据覆盖了。
所以,多进程修改同一文件的时候,需要协调每个进程:
这种协调方式可以通过文件锁来实现。
文件锁分两种,
当进程想要修改文件的时候,申请独占锁(写锁),当进程想要读取文件数据的时候,申请共享锁(读锁)。
独占锁和独占锁、独占锁和共享锁都是互斥的。
只要进程1持有了独占锁,进程2想要申请独占锁或共享锁都将失败(阻塞),也就保证了这一时刻只有进程1能修改文件,只有当进程1释放了独占锁,进程2才能继续申请到独占锁或共享锁。
但是共享锁和共享锁是可以共存的,这代表的是两个进程都只是要去读取数据,并不互相冲突。
Linux上的文件锁类型主要有两种:flock和lockf。后者是fcntl系统调用的一个封装。它们之间有些区别:
$var//=2:等价于 defined($var)||2,即 未定义 时才赋值为 2 ,否则不变( 即使是 空字符串 )$var||=2 :除非定义且为 true 才不会赋值,否则赋值(比如 空字符串 时)为2。$var='';
$var//=2;
print "'$var'\n";# perl atest4.pl
''$var=0;
$var//=2;
print "'$var'\n";# perl atest4.pl
'0'$var=1;
$var//=2;
print "'$var'\n";# perl atest4.pl
'1'$var=undef;
$var//=2;
print "'$var'\n";# perl atest4.pl
'2'$var='';
$var||=2;
print $var;# perl atest4.pl
2$var=0;
$var||=2;
print $var;# perl atest4.pl
2$var=1;
$var||=2;
print $var;# perl atest4.pl
1$var=undef;
$var||=2;
print $var;# perl atest4.pl
2-r: File is readable by effective uid/gid.
-w: File is writable by effective uid/gid.
-x: File is executable by effective uid/gid.
-o: File is owned by effective uid.
-R: File is readable by real uid/gid.
-W: File is writable by real uid/gid.
-X: File is executable by real uid/gid.
-O: File is owned by real uid.
-e: File exists.
-z: File has zero size (is empty).
-s: File has nonzero size (returns size in bytes).
-f: File is a plain file.
-d: File is a directory.
-l: File is a symbolic link.
-p: File is a named pipe (FIFO), or Filehandle is a pipe.
-S: File is a socket.
-b: File is a block special file.
-c: File is a character special file.
-t: Filehandle is opened to a tty.
-u: File has setuid bit set.
-g: File has setgid bit set.
-k: File has sticky bit set.
-T: File is an ASCII text file (heuristic guess).
-B: File is a "binary" file (opposite of -T).
-M: Script start time minus file modification time, in days.
-A: Same for access time.
-C: Same for inode change time (Unix, may differ for other platforms)要问何为 Web3,就先从什么味 Web2 和 Web1 来说起吧。
最近在网上看到 Web3 的概念很火热,比肩区块链、元宇宙,其实貌似一整个未来,特意整理一下认为比较好的材料分享出来。

截止目前,互联网技术大致进行过2次重要的革新,每个时代,都有其显著地时代特征。
虽然我很不喜欢这个词,但貌似事实如此。
早在上世纪 90 年代互联网刚刚开始普及的时候,用户与网络的互动处于非常早期的阶段,即用户只能被动地浏览文本、图片以及简单的视频内容,网站提供什么,用户查看什么。几乎没有互动可言。
上世纪 90 年代中后期,在谷歌、百度发展之前的一段时间,互联网曾经由 AltaVista 和 Netscape 主宰。当时,互联网的存在只是为了宣传他们的实体公司。这些网站是「只读网站」,意味着你只能搜索和阅读信息。

而那个时代的电子商务网站实际上跟现在超市发的促销手册一样,只是给你展示内容,你无法在网站上下单。
这就是 Web1.0,缓慢的 Web 1.0,完全受控制的 Web 1.0。
当前我们所处的这个时代,大致可理解为 WEB2.0
这一代互联网被称为「Web2.0」或「读写」网络。现在,用户不仅仅是单纯的访问者,他们还可以创建自己的内容,并将其上传到网站上。以著名的视频博主「办公室小野」为例,她仅用了 2 年的时间就从一个默默无闻的视频作者变成了月收入数千万的视频大 V。

有影响的网红只需要发一个视频就可以让一个餐馆排满长队,也可以用一句话让一家网店差评如潮。互联网人对于互联网的影响力与日俱增,以往网站给用户投喂信息的时代已经过去。
Web2.0 的主要目标是,使互联网更加民主,并尽可能地方便用户访问。
至于什么是 WEB3 还很难有一个准确的定义,但可以总结这么几个关键词:
在 WEB3.0 时代,身份认证有一个统一的平台,不再需要记录各个平台的账号密码,也不需要担心账号泄露;数据的确权与授权统一规范,不再是一家独大;个人隐私可以受到很好的保护,网站再也不能随意的跟踪用户行为;一切网络服务的运作,都是去中心化的。
至于具体改变了什么,未来将会是什么样子,可以想象。举个例子,某网盘再也不能随意的封禁用户数据,不可能因为新浪博客单方面的停止运营导致我们的博客内容无法访问,音乐资源不再局限于哪一家的版权,因为一切都是去中心化的。
当然改变越大,风险就越大,难度也越大。
怪不得最近总是看到有人说:不学习加密技术是自我毁灭。
就像是有些人已经成了比特币首富,有些人连什么是比特币还不清楚。一些人已经在闷声发大财,有些人还在固有的道路上艰难前进。
在将来,人们的使用习惯和生活方式可能会发生一些变化,比如现在常用 Chrome,未来可能使用 Brave。

信息就是金钱,随着 Web 3.0的出现,新的平台将以一种不被垄断服务提供商扼杀的健康竞争水平出现。
这个概念是这样的: 目前,分散的应用程序、钱包、平台以及其他构成 Web 3.0的数字资产是分散的。访问这些接口需要单独的种子、登录和身份标识,这与现有的 Web 2.0非常相似。将通过一个种子将这些不同的平台连接在一起。因为这将作为一个加密的钥匙,可以与其拥有者联系起来,艾森蒂亚将提供身份证明,但不会透露任何非必要的个人身份。
也许 WEB3 没有一个清晰地样子,只是不断的畅想未来的模型。如果一切明了,大概就是下一个时代的变革点了。因此抓住它,不要嫌弃它的简陋,要看到它就是未来。