[摘录]《OpenResty完全开发指南:构建百万级别并发的Web应用》 – 罗剑锋

OpenResty完全开发指南:构建百万级别并发的Web应用 罗剑锋 131个笔记

◆ 第1章 总论

[插图]

OpenResty使用四位数字作为版本号,形式是:a.b.c.x,其中前三位数字是内部Nginx的版本,作为大版本号,第四位数字是OpenResty自己的发布版本号,也就是小版本号

​​/usr/local/openresty/ #安装主目录
├── bin #存放可执行文件
├── luajit #LuaJIT运行库
├── lualib #Lua组件
├── nginx #Nginx核心运行平台
├── pod #参考手册(restydoc)使用的数据
└── site #包管理工具(opm)使用的数据​​

利用UNIX的“Shebang”(#! ),在脚本文件里的第一行指定resty作为解释器

[插图]

◆ 第2章 Nginx平台

Nginx是一个高性能、高稳定的轻量级HTTP、TCP、UDP和反向代理服务器

配置HTTP相关的功能需要使用指令http{},定义OpenResty里对外提供的HTTP服务,通常的形式是: ​​http { #http块开始,所有的HTTP相关功能
 server { #server块,第一个Web服务
 listen 80; #监听80端口
 location uri { #location块,需指定URI
 … #定义访问此URI时的具体行为
 } #location块结束
 } #server块结束
 server { #server块,第二个Web服务
 listen xxx; #监听xxx端口
 … #其他location定义
 } #server块结束
} #http块结束​​ 由于http块内容太多,如果都写在一个文件里可能会造成配置文件过度庞大,难以维护。

反向代理(Reverse Proxy)是现今网络中一种非常重要的技术,它位于客户端和真正的服务器(即所谓的后端)之间,接受客户端的请求并转发给后端,然后把后端的处理结果返回给客户端

◆ 第3章 Lua语言

Sol”这个词在葡萄牙语(巴西官方语言)里是太阳的意思,而“Lua”的意思就是月亮。

知名的应用有Adobe Lightroom、Fire-fox、Redis等,而游戏则有《魔兽世界》《愤怒的小鸟》《我的世界》等。

Lua语言提供六种基本的数据类型

Lua的字符串形式非常灵活,单引号或者双引号都可以,字符串里也允许使用转义符

Lua还用“[[…]]”的形式支持raw string,括号内的字符不会转义,在写正则表达式或者字符串里有引号、斜线的时候非常方便

与多行注释类似,“[[…]]”的形式也支持在括号中间插入“=”,而且如果“[[”后面是一个换行,那么Lua会自动忽略这个换行,在书写大量文字时是个非常方便的特性

Lua字符串的另外一个特点是只读的

Lua语言在内部使用一个全局散列表来管理所有的字符串,所以多个相同的字符串不会占用多份内存

Lua语言里的变量有作用域的概念,分为局部变量和全局变量,名字区分大小写

局部变量需要使用关键字“local”声明,作用域仅限本代码块(文件内或语句块内),没有关键字“local”声明的变量都是全局变量,而且不需要声明就可以直接使用

在Lua里应当尽量少使用全局变量,多使用局部变量

因为“局部化”,解释器查找的速度也更快

一个比较常用的全局变量是:“_”(下画线,也是合法的变量名)

Lua语言里没有“常量”,实践中我们通常用全大写名字的变量来表示常量

Lua里的运算有算术运算、关系运算、逻辑运算、字符串运算等

不等比较使用的是“~=”

在执行大于或小于比较操作时Lua会检查变量的类型,如果类型不同就会出错

但“==”和“~=”的行为则不同,如果类型不同会直接返回false

为了避免发生意外,必须用函数tonumber()/tostring()显式转换数字或字符串后再做比较运算

Lua的逻辑运算符有and、or和not三个

nil和false认为是假,其他都是真,包括数字0

x and y,如果x是真,返回y,否则返回x

x or y,与and操作正好相反,如果x是真,返回x,否则返回y

not x,只返回true/false,对x取反

Lua对字符串连接操作提供了一个特别的运算符“..”

连接运算还可以自动把数字转换为字符串,无须显式调用tostring()函数:

字符串连接操作应当尽量少用,因为每一次字符串连接就会创建一个新的字符串对象

如果多次操作超长字符串(例如几十MB的大块数据)就可能会导致LuaVM内存耗尽,发生错误。

计算字符串的长度可以用另一个特别的运算符“#”

字符串的关系运算基于字符序(例如最常用的ASCII码表)逐个检查,但相等比较是直接计算内部保存的散列值

很多时候对nil运算都会导致错误

如果一个变量可能是nil,最好使用or运算给它一个默认值

Lua里的语句包括赋值语句、分支语句和循环语句

Lua语句的格式非常自由,不强制要求缩进。语句末尾可以使用“;”表示结束,但不是必需的

使用“do…end”的形式就声明了一个语句(代码)块

Lua使用“=”在变量里存储一个确定类型的值

Lua还允许用逗号分隔,在一个语句里声明或赋值多个变量

如果给一个变量赋值为nil,就表示删除了这个变量

Lua的分支语句只有一种,就是if-else

多重分支需要使用“elseif”

Lua语言的循环语句有while、repeat-until和for三种

repeat-until循环与while差不多,但条件判断与while意义是相反的

Lua的for循环语句有两种形式:数值循环和范围循环

for的数值循环类似其他语言的标准for语句,但形式上要简洁一些

变量var从m前进(或后退)到n,执行循环体里的语句,参数step是用于控制var前进或后退的步长,可以省略,默认是1

for循环里的变量var会自动声明为局部变量

可以用break或者return直接跳出循环,用法与其他语言相同,但必须在语句块的最后——也就是后面紧跟着end/until关键字

如果想要在任意的位置结束循环,可以使用“do break end”的形式

OpenResty使用的LuaJIT扩展支持goto,可以变通实现continue

在Lua语言里函数是一类特殊的变量,它持有一个语句块,能够使用参数执行语句块(也就是“调用”),然后返回结果

Lua的函数就是变量,也可以(最好)使用local局部化。

可以传入任意数量的实参,少的默认值是nil,多的则被忽略

函数的返回值使用return语句,可以用逗号分隔返回多个值,但如果被调用时使用圆括号包围则只会返回一个值

Lua函数的参数都是传值(但表除外)

如果调用时只有一个传入的参数,而且这个参数是字符串或者表,那么Lua允许省略函数的“()”,直接在函数名后写参数

但Lua的表更加灵活,能够模拟出array、list、dict、set、map等常见数据结构,或者其他任意复杂的结构

Lua表里作为索引的key可以是任何非nil值,所以当key类型是整数时表就相当于数组,key类型是字符串时表就相当于字典或关联数组

Lua表对value的类型没有任何限制,当然也可以是另外一个表,从而实现多个表的嵌套。

Lua里定义表使用花括号“{}”

直接使用“{}”就是一个空表,在里面简单地列出表内的元素就声明了一个数组形式的表,使用“key=value”的形式就可以声明为字典形式的表

使用“key=value”的形式时key不需要用单引号或双引号,如果必须要用(例如key里有空格或者其他特殊符号)则要使用“[key]=value”的形式

定义表时的逗号“,”也可以改用分号“;”,两者没有不同,但可以做一些形式上的区分

Lua的表是动态的数据结构,不仅可以访问已有的元素,也可以随时向表里添加或删除元素

操作表里的元素需要使用方括号“[]”

当表作为数组来使用时整数下标索引必须从1开始计数

如果key是字符串我们也可以直接使用点号“.”来操作

运算符“#”可以计算形式表里的数组元素数量,配合for循环可以实现遍历数组

对于字典形式的表,暂时没有办法能够直接获取元素的数量,使用“#”会返回0

for循环语句的第二种形式——范围循环主要用于遍历表里的元素,但需要两个标准库函数的配合:ipairs()和pairs()。

模块就是一个函数集合,通常表现为一个Lua表,里面有模块作者提供的各种功能函数,使用点号“.”即可访问

使用require函数可以加载模块,参数是模块所在的文件名(省略后缀)

通常我们需要用变量来保存require函数的返回结果

require在加载模块的同时会执行文件里的代码

如果使用字符串作为key,那么表本身就是对象,可以任意存储变量和函数

封装”方面,Lua不提供private、public这样的修饰词,表里的所有成员都是公开的

如果想要实现私有成员,那么可以在模块文件里用local修饰

“多态”特性对于Lua来说非常简单,由于表是动态的,里面的成员都能够在运行时随意替换,没有编译型语言静态绑定的烦恼。

继承”在Lua语言里是不提倡的特性,替代方案是使用“原型”(prototype)模式,从一个“原型”对象“克隆”出一个新对象,然后再动态变更其属性,从而达到与“继承”类似的效果。

“原型”模式需要使用Lua的高级特性“元表”(metatable)和函数setmetatable()。

元表描述了表的基本行为,有些类似C++或者Python里的操作符重载,我们需要用的是“__index”元方法,它重载了Lua里查找key的操作,也就是table.key。

函数setmetatable(t, meta)把表t的元表设置为meta并返回t。

如果meta里设置了“index”方法,那么对t的操作t.key也会同样作用到meta上,即meta.key。这样,表t就“克隆”了表meta的所有成员,表meta就成为了表t的“原型”。 可以通过下面的例子来进一步理解Lua的“原型”操作: ​​local proto = {} — 首先声明一个原型对象,暂时是空表
function proto.go() — 为表添加一个方法,即成员函数
 print(“go pikachu”)
end
local mt = { index = proto } — 定义元表,注意重载了“index”
local obj = setmetatable({}, mt) — 调用setmetatable设置元表,返回新表
obj.go() — 新对象是原型的“克隆”,可以执行原型的操作​​ 代码里的关键操作是定义元表mt,里面只需要设置“index”方法,然后再使用函数setmetatable从mt克隆出一个新的对象。 这两个步骤也可以合并为一次操作:

Lua为面向对象的方式使用表内成员函数提供一个特殊的操作符“:”,它的功能与“.”基本相同,但在调用函数时会隐含传入一个“self”参数

“:”和self不仅可以用在函数调用时,也可以用在函数定义时

“:”其实是一种“语法糖”,是简化的“.”写法

建议尽量使用“:”,它更简洁一些

应该用OpenResty自己的ngx.re系列函数

过table.insert的效率并不高,我们可以用如下的方式更高效地在末尾添加元素:

a[#a + 1] = ‘nginx’ — 利用“#”运算符获取长度来添加元素​​

io库里是操作文件的函数,由于文件通常存储在磁盘上,而且是阻塞操作,速度很慢,在OpenResty里应当尽量少用。

在读取数据时,可以使用参数“a”(即all)读取整个文件,或者“l”(即line)读取一行,使用数字则读取指定长度的字节

os库包含有操作系统和时间日期相关的函数

形象(但不很准确)地来说,“闭包”就是一个“活的函数”,存在于程序的“高维空间”,可以任意操作函数外部的数据

如果想要Lua代码更加健壮,我们可以使用保护模式来执行可能出错的函数

pcall(protected call)是base库里的一个特殊函数,它“保护调用”一个函数,绝对不会出错,并以true/false返回调用结果

◆ 第4章 LuaJIT环境

LuaJIT是Lua语言的另一个实现,包括一个汇编语言编写的解释器和一个JIT编译器

使用“::label::”的形式定义标签,之后就可以随时用goto改变程序的流程

LuaJIT增强了table库,为它添加了一些新函数,其中较有用的有table.new、table.clear和table.clone。

函数table.clear把表置为空表,但保留之前分配的内存

函数table.clone是OpenResty的LuaJIT分支独有特性,可以高效地“浅”拷贝表(shallow clone)

ffi库不仅可以调用系统函数和OpenResty内部的C函数,还可以加载so形式的动态库,调用动态库里的函数

LuaJIT总是先用解释器运行编译后的字节码,并在运行时做“热点分析”,如果某段代码足够“热”,就会自动触发JIT编译器,尝试把字节码再编译成本地的机器码,让程序能够以最快的速度运行。

有的Lua函数因为实现的代价较高所以不会被编译,只能以字节码的形式运行,这些被称为NYI(Not Yet Implemented)。

◆ 第5章 开发概述

OpenResty提供一个专用指令“content_by_lua_block”,可以在配置文件里书写Lua代码,产生响应内容

启动应用需要使用“-c”参数,让OpenResty以指定的配置文件运行:/usr/local/openresty/bin/openresty -c “pwd/hello.conf”

5.1节的例子是最简单的OpenResty应用,只有一个配置文件,应用代码写在了配置文件里。但实际的项目要比它复杂很多,配置文件和应用代码最好分离管理维护,此外还会有其他的监控脚本、日志文件、数据文件等,必须要用很好的目录层次把它们组织起来。 通常一个OpenResty应用的目录结构如下:[插图] ​​path/to/application #应用的主目录
├── bin #脚本目录,存放各种脚本文件
├── conf #配置目录,存放Nginx配置文件
│ ├── http #存放HTTP服务的配置文件
│ ├── stream #存放TCP/UDP服务的配置文件

在OpenResty里ngx_lua和stream_lua分别属于两个不同的子系统,但指令的功能和格式基本相同

OpenResty目前关注的是initing和running这两个阶段,并做了更细致的划分。

开发者必须较好地理解这些阶段的含义和作用,再结合自己的实际业务需求,选择恰当的阶段编写代码实现功能

OpenResty使用“定时器”来周期性地(一次或多次)执行“后台任务”。

这些接口大部分位于全局表ngx里,无须require即可访问(不过也有部分例外)

与Lua自带的标准库函数不同,它们基于Nginx的事件机制和Lua的协程特性,都是“100% nonblocking”的,能够让我们轻松编写出同步非阻塞的高效代码

OpenResty自带了很多Lua库(位于安装目录的lualib内), lua-resty-core是其中最重要的一个,它使用ffi重新实现了OpenResty里原有的大多数函数,并增加了一些新的功能。

◆ 第6章 基础功能

ngx.sleep是OpenResty提供的同步非阻塞的睡眠函数,可以“睡眠”任意的时间长度但不会阻塞整个服务,这时OpenResty会基于协程机制转而处理其他的请求,等睡眠时间到再“回头”继续执行ngx.sleep后续的代码。

MessagePack是一种二进制数据编码格式,与JSON相比更加小巧紧凑,适合序列化传输大批量的数据。

OpenResty在表ngx.re里提供六个正则表达式相关函数,它们的底层实现是PCRE库,速度极快,完全可以代替Lua标准库的字符串匹配函数

正则替换也有两个函数:ngx.re.sub和ngx.re.gsub,我们在使用时最好不要加“o”选项(原因见6.5.2节

ngx.re.gsub是ngx.re.sub的增强版,可以执行多次正则替换

Cache的容量通常都是有限的,需要使用某种算法更新淘汰数据,较常见的有FIFO、LFU、LRU等

OpenResty基于LRU算法提供了一个方便易用的Cache库lua-resty-lru-cache,并且支持过期时间功能(expire)

cache对象的功能接口十分简单易用,提供基本的set/get/delete等操作,用起来就像是一个Key-Value的散列表,缓存内的元素也可以是任何Lua数据(数字、字符串、函数、表等),无须序列化或反序列化

◆ 第7章 HTTP服务

状态码表示HTTP请求的处理状态,目前RFC规范里有一百多个,在OpenResty里只定义了少量最常见的,

◆ 第8章 访问后端

必须利用Redis、MySQL等数据库服务存储缓存、会话和其他数据,利用Kafka、RabbitMQ等消息队列服务异步发送消息,以及访问Tomcat、PHP等业务服务,访问ZooKeeper、Consul等配置服务,综合协调这些后端才能为最终用户呈现出一个功能完备的应用服务。

第一反应要三思

人的第一反应或许常常是处于本能的,

而本能或是条件反射多是为了生存思考,

这种条件下产生的行为一定是“自私”的。

时常管好自己的第一反应,

这种行为也分为多种境界。

一句话脱口而出之前好好想想,是不是出于本能,是不是出于条件反射。

如果是,那就三思,充分思考过后再说,毕竟说出去的话是收不回来的。

另一层境界,一件事情发生之前,第一反应的思考方向。

产生这种想法,首先判断一下,是不是出于本能,是不是条件反射。

如果是,思考一下这种思路是不是真的有用,是不是真的为大局考虑。

如果有悖这几个方向,那就得调整一下。

毕竟思路错了,行为就错了,犯下的错误更加深远,更加难以挽回。

坚持习惯从身边的点滴做起

每天都想早睡,但有时候就是容易晚睡,如何才能实现早点睡呢。

发现其实也很简单,将睡下之前的所有工序提早做完,再去做可能拖延的事情。

以我自己为例,可能导致我晚睡的大概有这几种事情:

  1. 看书看入迷;
  2. 看电影或电视剧入迷;
  3. 做东西、研究某样技术入迷;
  4. 了解某样知识入迷;
  5. 做东西入迷。

这些事情都有一个共同的特征,那就是灵活性极强,可以搞很久很久,也可以很快结束。

那么耽误我入睡的事情都有哪些呢:

  1. 洗漱花费时间;
  2. 洗澡洗衣服花费时间;
  3. 不想洗衣服花费时间;

综上,如果以上两个清单中同时有情况命中,那我当天一定就是晚睡无疑了。

破解的方法也很简单,那就是现在就去做。

如果我想要早睡,那我就把睡前所有工序完成,只要我想立刻就能去睡。

另外,把那些自己不想做的事情,现在就做掉。

比如我不想洗袜子、洗衣服,因为不想做这件事可能就会拖延到很久,很多次因为这种事情拖延到两三点才睡。拖到最后还不是要做的,那就赶快去做了,然后再来做自己入迷的事情。

将那些可能分担自己精力的事情先做完,然后集中精力做那些需要聚精会神的事情。

如此一来,既能不耽误事情,又能养成良好习惯。

总结一下,想要坚持好喜欢,又想要做想做的事,两全其美的方法,就是现在就去做。

前事不忘,后事之师

前事不忘,后事之师。

今天,是我国第9个 南京大屠杀死难者国家公祭日 85年前的今天 侵华日军制造了 惨绝人寰的大屠杀

那段痛苦的历史,是所有中国人不能忘却的记忆。 通过纪念日的形式,每年加强一次, 所有中国人绝对不能忘记。

还记得那年在南京城, 侵华日军南京大屠杀遇难同胞纪念馆。

一个个令人痛彻心扉的数字, 一幅幅令人毛骨悚然的照片, 一件件指向罪恶之人的铁证, 无一不让我刻骨铭心。

作为后人, 能做的就是不要忘记, 让这段痛苦的历史, 成为自己日后向上的动力, 努力让自己变得更强大, 如果可能, 为强大的祖国奉献微薄之力。

参考文献

精神力充能跟吃饭一样重要

除了吃饭,好要注意补充精神力。

吃饭可以补充能量,让人有力气去做事情。

但越发的发现,吃饭不能补充人的精神力。

每天面对错综复杂的现实情况,我们的精神世界很容易疲惫。

为了生存,需要用最大的力气去努力做事。

出了耗费自己的力气,对于精神力也是一种损耗。

补充精神力的方式,因人而异。

可能是看书、看电影、听音乐、一个人走路,甚至是,看《爱情公寓》?

总结一下,但凡事能够让自己感到轻松,带来勇气的事情,就可以用来充能。每个人方式不同,根据自己的实际情况调整。

我愿称这种力之为“精神力”,其重要地位仅次于吃饭。

事事有回音,才更容易坚持

写完程序,做一做代码扫描、代码评级检测、单元测试覆盖率检测,看到那个很直观且能够努力有所提升的具体的数值,就更有力气为之努力。

写完文字,看着发文数量,评论数量,阅读数量,一天天增加,就更有力气。

做完事情,一条一条列出来,就更加有斗志。

做的事情列出甘特图,总结起来就很有成就感。

让一个个目标和进度摆在眼前,选一两个最具说服力的量化指标放在桌面,这样会让自己更容易坚持!

很喜欢简书的这个小插件,有无日更一目了然:

我将这个小组件放在了第一屏,这也给我很大的启发。

或许未来,我可以在做其他事情时,使用类似的形式激励和提醒自己。

无论结果如何,坚持下去,就很不容易。

本文介绍了一种简单粗暴且有效的方法,有助于坚持去做一件事。

让我们一起努力吧!

[摘录]《Go语言精进之路:从新手到高手的编程思想、方法和技巧1 – 白明》

Go语言精进之路:从新手到高手的编程思想、方法和技巧1 白明 330个笔记

◆ 第一部分 熟知Go语言的一切

golang仅应用于命名Go语言官方网站,当时之所以使用golang.org作为Go语言官方域名,是因为go.com已经被迪士尼公司占用了。

Go语言项目在2009年11月10日正式开源,这一天也被Go官方确定为Go语言诞生日

Go程序员也被昵称为Gopher(后文会直接使用Gopher指代Go语言开发者),Go语言官方技术大会被称为GopherCon。

国内最负盛名的Go技术大会同样以Gopher命名,被称为GopherChina。

 图2-1 Go语言的先祖(图片来自《Go程序设计语言》一书

Go的基本语法参考了C语言,Go是“C家族语言”的一个分支;而Go的声明语法、包概念则受到了Pascal、Modula、Oberon的启发;一些并发的思想则来自受到Tony Hoare教授CSP理论[1]影响的编程语言,比如Newsqueak和Limbo。

如今,Go团队已经将版本发布节奏稳定在每年发布两次大版本上,一般是在2月和8月。Go团队承诺对最新的两个Go稳定大版本提供支持

Go语言提供的最为直观的组合的语法元素是类型嵌入(type embedding)。

interface是Go语言中真正的“魔法”,是Go语言的一个创新设计,它只是方法集合,且与实现者之间的关系是隐式的,它让程序各个部分之间的耦合降至最低,同时是连接程序各个部分的“纽带”

综上,组合原则的应用塑造了Go程序的骨架结构。类型嵌入为类型提供垂直扩展能力,interface是水平组合的关键,它好比程序肌体上的“关节”,给予连接“关节”的两个部分各自“自由活动”的能力,而整体上又实现了某种功能

Go的设计者敏锐地把握了CPU向多核方向发展的这一趋势,在决定不再使用C++而去创建一门新语言的时候,果断将面向多核、原生内置并发支持作为新语言的设计原则之一。

操作系统调度器会将系统中的多个线程按照一定算法调度到物理CPU上运行

传统编程语言(如C、C++等)的并发实现实际上就是基于操作系统调度的,即程序负责创建线程(一般通过pthread等函数库调用实现),操作系统负责调度。这种传统支持并发的方式主要有两大不足:复杂和难于扩展。

虽然线程的代价比进程小了很多,但我们依然不能大量创建线程,因为不仅每个线程占用的资源不小,操作系统调度切换线程的代价也不小。

对于很多网络服务程序,由于不能大量创建线程,就要在少量线程里做网络的多路复用,即使用epoll/kqueue/IoCompletionPort这套机制

即便有了libevent、libev这样的第三方库的帮忙,写起这样的程序也是很不容易的,存在大量回调(callback),会给程序员带来不小的心智负担。

goroutine占用的资源非常少,Go运行时默认为每个goroutine分配的栈空间仅2KB。

goroutine调度的切换也不用陷入(trap)操作系统内核层完成,代价很低

将这些goroutine按照一定算法放到CPU上执行的程序就称为goroutine调度器(goroutine scheduler)。

并发程序的结构设计不要局限于在单核情况下处理能力的高低,而要以在多核情况下充分提升多核利用率、获得性能的自然提升为最终目的。

Go设计者将所有工程问题浓缩为一个词:scale(笔者总觉得将scale这个词翻译为任何中文词都无法传神地表达其含义,暂译为“规模”吧)。

生产规模:用Go构建的软件系统的并发规模,比如这类系统并发关注点的数量、处理数据的量级、同时并发与之交互的服务的数量等。

开发规模:包括开发团队的代码库的大小,参与开发、相互协作的工程师的人数等。

在处理依赖关系时,有时会通过允许一部分重复代码来避免引入较多依赖关系

包路径是唯一的,而包名不必是唯一的

• 构建和运行:go build/go run • 依赖包查看与获取:go list/go get/go mod xx • 编辑辅助格式化:go fmt/gofmt • 文档查看:go doc/godoc • 单元测试/基准测试/测试覆盖率:go test • 代码静态分析:go vet • 性能剖析与跟踪结果查看:go tool pprof/go tool trace • 升级到新Go版本API的辅助工具:go tool fix • 报告Go语言bug:go bug

。德国建筑大师路德维希·密斯·凡德罗将“少即是多”这一哲学理念应用到建筑设计当中后取得了非凡的成功,而Go语言则是这一哲学在编程语言领域为数不多的践行者。

“少”绝不是目的,“多”才是其内涵

“高内聚、低耦合”是软件开发领域亘古不变的管理复杂性的准则

在人类自然语言学界有一个很著名的假说——“萨丕尔-沃夫假说”,这个假说的内容是这样的:“语言影响或决定人类的思维方式。”

首届图灵奖得主、著名计算机科学家艾伦·佩利(Alan J. Perlis),他从另外一个角度提出:“不能影响到你的编程思维方式的编程语言不值得学习和使用。”

针对这个问题,我们可以采用埃拉托斯特尼素数筛算法。

先用最小的素数2去筛,把2的倍数筛除;下一个未筛除的数就是素数(这里是3)。再用这个素数3去筛,筛除3的倍数……这样不断重复下去,直到筛完为止

Go版本程序实现了一个并发素数筛,它采用的是goroutine的并发组合

程序从素数2开始,依次为每个素数建立一个goroutine,用于作为筛除该素数的倍数

ch指向当前最新输出素数所位于的筛子goroutine的源channel。这段代码来自Rob Pike的一次关于并发的分享

Go版本程序的执行过程可以用图4-2立体地展现出来。  图4-2 Go版本素数筛运作的示意图

C的命令式思维、Haskell的函数式思维和Go的并发思维

编程语言影响编程思维,或者说每种编程语言都有属于自己的原生编程思维

但凡属于某个编程语言的高质量范畴的代码,其必定是在这种编程语言原生思维下编写的代码

以一门编程语言为中心的,以解决工程问题为目标的编程语言用法、辅助库、工具的固定使用方法称为该门编程语言的原生编程思维

[插图]

◆ 第二部分 项目结构、代码风格与标识符命名

截至Go项目commit 1e3ffb0c(2019.5.14),Go项目结构如下: $ tree -LF 1 ~/go/src/github.com/golang/go
./go
├── api/
├── AUTHORS
├── CONTRIBUTING.md
├── CONTRIBUTORS
├── doc/
├── favicon.ico
├── lib/
├── LICENSE
├── misc/
├── PATENTS
├── README.md
├── robots.txt
├── src/
└── test/

1)代码构建的脚本源文件放在src下面的顶层目录下。

2)src下的二级目录cmd下面存放着Go工具链相关的可执行文件(比如go、gofmt等)的主目录以及它们的main包源文件。

3)src下的二级目录pkg下面存放着上面cmd下各工具链程序依赖的包、Go运行时以及Go标准库的源文件。

Russ Cox在一个开源项目的issue中给出了他关于Go项目结构的最小标准布局[1]的想法。他认为Go项目的最小标准布局应该是这样的: // 在Go项目仓库根路径下

- go.mod
- LICENSE
- xx.go
- yy.go
… 或

  • go.mod
- LICENSE
- package1
 – package1.go
- package2
 – package2.go
…

 图5-1 Go语言典型项目结构(以构建二进制可执行文件为目的的Go项目)

 图5-2 Go语言库项目结构

Go核心团队将这类问题归结为一个词——规模化(scale),这也是近几年比较火热的Go2演进方案将主要解决的问题

Go官方在gofmt中提供了-s选项。通过gofmt -s可以将遗留代码中的非简化代码自动转换为简化写法,并且没有副作用,因此一般“-s”选项都会是gofmt执行的默认选项。

我们可以通过-r命令行选项对代码进行表达式级别的替换,以达到重构的目的。

gofmt -r的原理就是在对源码进行重新格式化之前,搜索源码是否有可以匹配pattern的表达式,如果有,就将所有匹配到的结果替换为replacement表达式。

gofmt提供了-l选项,可以按格式要求输出满足条件的文件列表

goimports在gofmt功能的基础上增加了对包导入列表的维护功能,可根据源码的最新变动自动从导入包列表中增删包。

Go和Vim通过vim-go插件连接在一起

计算机科学中只有两件难事:缓存失效和命名。 ——Phil Karlton,Netscape架构师

但简单并不意味着一味地为标识符选择短小的名字,而是要选择那种可以在标识符所在上下文中保持其用途清晰明确的名字

要想做好Go标识符的命名(包括对包的命名),至少要遵循两个原则:简单且一致;利用上下文辅助命名。

对于Go中的包(package),一般建议以小写形式的单个单词命名。

在Go中变量分为包级别的变量和局部变量(函数或方法内的变量)

Go语言官方要求标识符命名采用驼峰命名法(CamelCase)

为变量、类型、函数和方法命名时依然要以简单、短小为首要原则。

• 循环和条件变量多采用单个字母命名(具体见上面的统计数据); • 函数/方法的参数和返回值变量以单个单词或单个字母为主; • 由于方法在调用时会绑定类型信息,因此方法的命名以单个单词为主; • 函数多以多单词的复合词进行命名; • 类型多以多单词的复合词进行命名。

变量名字中不要带有类型信息

保持变量声明与使用之间的距离越近越好,或者在第一次使用变量之前声明该变量

保持简短命名变量含义上的一致性

常量多使用多单词组合的方式命名

Go语言中的接口是Go在编程语言层面的一个创新,它为Go代码提供了强大的解耦合能力

在Go语言中,对于接口类型优先以单个单词命名。

对于拥有唯一方法(method)或通过多个拥有唯一方法的接口组合而成的接口,Go语言的惯例是用“方法名+er”命名

Go语言推荐尽量定义小接口,并通过接口组合的方式构建程序

Go在给标识符命名时还有着考虑上下文环境的惯例,即在不影响可读性的前提下,兼顾一致性原则,尽可能地用短小的名字命名标识符

◆ 第三部分 声明、类型、语句与控制结构

对于以面向工程著称且以解决规模化问题为目标的Go语言,Gopher在变量声明形式的选择上应尽量保持项目范围内一致。

包级变量(package variable):在package级别可见的变量。如果是导出变量,则该包级变量也可以被视为全局变量

局部变量(local variable):函数或方法体内声明的变量,仅在函数或方法体内可见。

包级变量只能使用带有var关键字的变量声明形式,但在形式细节上仍有一定的灵活度。

我们一般将同一类的变量声明放在一个var块中,将不同类的声明放在不同的var块中;或者将延迟初始化的变量声明放在一个var块,而将声明并显式初始化的变量放在另一个var块中。笔者称之为“声明聚类”。

变量声明最佳实践中还有一条:就近原则,即尽可能在靠近第一次使用变量的位置声明该变量。就近原则实际上是变量的作用域最小化的一种实现手段

如果一个包级变量在包内部被多处使用,那么这个变量还是放在源文件头部声明比较适合。

对于延迟初始化的局部变量声明,采用带有var关键字的声明形式

另一种常见的采用带var关键字声明形式的变量是error类型的变量err(将error类型变量实例命名为err也是Go的一个惯用法),尤其是当defer后接的闭包函数需要使用err判断函数/方法退出状态时

对于声明且显式初始化的局部变量,建议使用短变量声明形式

尽量在分支控制时应用短变量声明形式

 图8-1 变量声明形式使用决策流程图

在C语言中,字面值(literal)担负着常量的角色(针对整型值,还可以使用枚举常量)。

为了不让这些魔数(magic number)充斥于源码各处,早期C语言的常用实践是使用宏(macro)定义记号来指代这些字面值

宏定义的常量有着诸多不足,比如: • 仅是预编译阶段进行替换的字面值,继承了宏替换的复杂性和易错性; • 是类型不安全的; • 无法在调试时通过宏名字输出常量的值。

Go语言中的const整合了C语言中宏定义常量、const只读变量和枚举常量三种形式,并消除了每种形式的不足,使得Go常量成为类型安全且对编译器优化友好的语法元素。

绝大多数情况下,Go常量在声明时并不显式指定类型,也就是说使用的是无类型常量(untyped constant)

Go要求,两个类型即便拥有相同的底层类型(underlying type),也仍然是不同的数据类型,不可以被相互比较或混在一个表达式中进行运算:

Go的设计者认为,隐式转换带来的便利性不足以抵消其带来的诸多问题[1]。

Go的const语法提供了“隐式重复前一个非空表达式”的机制

iota是Go语言的一个预定义标识符,它表示的是const声明块(包括单行声明)中每个常量所处位置在块中的偏移值(从零开始)

GOROOT/src/sync/mutex.go (go 1.12.7)
const (
 mutexLocked = 1 << iota
 mutexWoken
 mutexStarving
 mutexWaiterShift = iota
 starvationThresholdNs = 1e6
)

iota预定义标识符能够以更为灵活的形式为枚举常量赋初值

Go的枚举常量不限于整型值,也可以定义浮点型的枚举常量

iota使得维护枚举常量列表更容易

使用有类型枚举常量保证类型安全

保持零值可用。 ——Go谚语

虽然一些编译器的较新版本提供了一些命令行参数选项用于对栈上变量进行零值初始化,比如GCC就提供如下命令行选项:

但这并不能改变C语言原生不支持对未显式初始化局部变量进行零值初始化的事实

由于Go中的切片类型具备零值可用的特性,我们可以直接对其进行append操作,而不会出现引用nil的错误

Go标准库的设计者很贴心地将sync.Mutex结构体的零值设计为可用状态,让Mutex的调用者可以省略对Mutex的初始化而直接使用Mutex。

零值可用也有一定的限制,比如:在append场景下,零值可用的切片类型不能通过下标形式操作数据

像map这样的原生类型也没有提供对零值可用的支

另外零值可用的类型要注意尽量避免值复制

有些时候,零值并非最好的选择,我们有必要为变量赋予适当的初值以保证其后续以正确的状态参与业务流程计算,尤其是Go语言中的一些复合类型的变量。

Go语言中的复合类型包括结构体、数组、切片和map

Go提供的复合字面值(composite literal)语法可以作为复合类型变量的初值构造器

复合字面值由两部分组成:一部分是类型,比如上述示例代码中赋值操作符右侧的myStruct、[5]int、[]int和map[int]string;另一部分是由大括号{}包裹的字面值。

如果源码中使用了从另一个包中导入的struct类型,但却未使用field:value形式的初值构造器,则该规则认为这样的复合字面值是脆弱的

不允许将从其他包导入的结构体中的未导出字段作为复合字面值中的field,这会导致编译错误。

与结构体类型不同,数组/切片使用下标(index)作为field:value形式中的field,从而实现数组/切片初始元素值的高级构造形式

但是对于map类型(这一语法糖在Go 1.5版本中才得以引入)而言,当key或value的类型为复合类型时,我们可以省去key或value中的复合字面量中的类型

对于零值不适用的场景,我们要为变量赋予一定的初值

每当你花费大量时间使用某种特定工具时,深入了解它并了解如何高效地使用它是很值得的。

slice,中文多译为切片,是Go语言在数组之上提供的一个重要的抽象数据类型。在Go语言中,对于绝大多数需要使用数组的场合,切片实现了完美替代。并且和数组相比,切片提供了更灵活、更高效的数据序列访问接口。

Go语言数组是一个固定长度的、容纳同构类型元素的连续序列,因此Go数组类型具有两个属性:元素类型和数组长度。这两个属性都相同的数组类型是等价的

Go数组是值语义的,这意味着一个数组变量表示的是整个数组,这点与C语言完全不同。

在Go语言中,更地道的方式是使用切片。 切片之于数组就像是文件描述符之于文件

在Go语言中,数组更多是“退居幕后”,承担的是底层存储空间的角色;而切片则走向“前台”,为底层的存储(数组)打开了一个访问的“窗口”(见图13-1)。

我们可以称切片是数组的“描述符”

//$GOROOT/src/runtime/slice.go
type slice struct {
 array unsafe.Pointer
 len int
 cap int
}

我们可以通过语法u[low: high]创建对已存在数组进行操作的切片,这被称为数组的切片化(slicing)

还可以通过语法s[low: high]基于已有切片创建新的切片,这被称为切片的reslicing

新创建的切片与原切片同样是共享底层数组的,并且通过新切片对数组的修改也会反映到原切片中。

Go切片还支持一个重要的高级特性:动态扩容

这样的append操作有时会给Gopher带来一些困惑,比如通过语法u[low: high]形式进行数组切片化而创建的切片,一旦切片cap触碰到数组的上界,再对切片进行append操作,切片就会和原数组解除绑定

append操作是一件利器,它让切片类型部分满足了“零值可用”的理念

但从append的原理中我们也能看到重新分配底层数组并复制元素的操作代价还是挺大的,尤其是当元素较多的情况下。那么如何减少或避免为过多内存分配和复制付出的代价呢?一种有效的方法是根据切片的使用场景对切片的容量规模进行预估,并在创建新切片时将预估出的切片容量数据以cap参数的形式传递给内置函数make

由结果可知,使用带cap参数创建的切片进行append操作的平均性能(9250ns)是不带cap参数的切片(36 484ns)的4倍左右,并且每操作平均仅需一次内存分配

key的类型应该严格定义了作为“==”和“!=”两个操作符的操作数时的行为

创建map类型变量有两种方式:一种是使用复合字面值,另一种是使用make这个预声明的内置函数。

和切片一样,map也是引用类型,将map类型变量作为函数参数传入不会有很大的性能损耗,并且在函数内部对map变量的修改在函数外部也是可见的

Go语言的一个最佳实践是总是使用“comma ok”惯用法读取map中的值。

即便要删除的数据在map中不存在,delete也不会导致panic

我们看到对同一map做多次遍历,遍历的元素次序并不相同。这是因为Go运行时在初始化map迭代器时对起始位置做了随机处理

千万不要依赖遍历map所得到的元素次序。

如果你需要一个稳定的遍历次序,那么一个比较通用的做法是使用另一种数据结构来按需要的次序保存key,比如切片

Go运行时使用一张哈希表来实现抽象的map类型。运行时实现了map操作的所有功能,包括查找、插入、删除、遍历等

考虑到map可以自动扩容,map中数据元素的value位置可能在这一过程中发生变化,因此Go不允许获取map中value的地址,这个约束是在编译期间就生效的。

如果可能的话,我们最好对map使用规模做出粗略的估算,并使用cap参数对map实例进行初始化

使用cap参数的map实例的平均写性能是不使用cap参数的2倍。

在能预估出最终字符串长度的情况下,使用预初始化的strings.Builder连接构建字符串效率最高

strings.Join连接构建字符串的平均性能最稳定,如果输入的多个字符串是以[]string承载的,那么strings.Join也是不错的选择

使用操作符连接的方式最直观、最自然,在编译器知晓欲连接的字符串个数的情况下,使用此种方式可以得到编译器的优化处理

fmt.Sprintf虽然效率不高,但也不是一无是处,如果是由多种不同类型变量来构建特定格式的字符串,那么这种方式还是最适合的

无论是string转slice还是slice转string,转换都是要付出代价的,这些代价的根源在于string是不可变的,运行时要为转换后的类型分配新内存

Go要求包之间不能存在循环依赖,这样一个包的依赖关系便形成了一张有向无环图。由于无环,包可以被单独编译,也可以并行编译。

和主流静态编译型语言一样,Go程序的构建简单来讲也是由编译(compile)和链接(link)两个阶段组成的

编译器在编译过程中必然要使用的是编译单元(一个包)所依赖的包的源码。

包名与包导入路径中的最后一个目录名不同时,最好用下面的语法将包名显式放入包导入语句。

支持在同一行声明和初始化多个变量(不同类型也可以)

支持在同一行对多个变量进行赋值

表达式的求值顺序在任何一门编程语言中都是比较“难缠的”

在一个Go包内部,包级别变量声明语句的表达式求值顺序是由初始化依赖(initialization dependencies)规则决定的。

在Go包中,包级别变量的初始化按照变量声明的先后顺序进行

如果某个变量(如变量a)的初始化表达式中直接或间接依赖其他变量(如变量b),那么变量a的初始化顺序排在变量b后面。

未初始化的且不含有对应初始化表达式或初始化表达式不依赖任何未初始化变量的变量,我们称之为“ready for initialization”变量。

包级别变量的初始化是逐步进行的,每一步就是按照变量声明顺序找到下一个“ready for initialization”变量并对其进行初始化的过程。反复重复这一步骤,直到没有“ready for initialization”变量为止。

位于同一包内但不同文件中的变量的声明顺序依赖编译器处理文件的顺序:先处理的文件中的变量的声明顺序先于后处理的文件中的所有变量。

先来看switch-case语句中的表达式求值,这类求值属于“惰性求值”范畴。惰性求值指的就是需要进行求值时才会对表达值进行求值,这样做的目的是让计算机少做事,从而降低程序的消耗,对性能提升有一定帮助

select执行开始时,首先所有case表达式都会被按出现的先后顺序求值一遍

有一个例外,位于case等号左边的从channel接收数据的表达式(RecvStmt)不会被求值

如果选择要执行的是一个从channel接收数据的case,那么该case等号左边的表达式在接收前才会被求值

表达式本质上就是一个值,表达式求值顺序影响着程序的计算结果。

包级别变量声明语句中的表达式求值顺序由变量的声明顺序和初始化依赖关系决定,并且包级变量表达式求值顺序优先级最高。

表达式操作数中的函数、方法及channel操作按普通求值顺序,即从左到右的次序进行求值。

赋值语句求值分为两个阶段:先按照普通求值规则对等号左边的下标表达式、指针解引用表达式和等号右边的表达式中的操作数进行求值,然后按从左到右的顺序对变量进行赋值。

重点关注switch-case和select-case语句中的表达式“惰性求值”规则

只有深入了解了Go代码块与作用域规则,才能理解这段代码输出“1 2 3”的真正原因。

代码块是代码执行流流转的基本单元,代码执行流总是从一个代码块跳到另一个代码块

Go语言中有两类代码块,一类是我们在代码中直观可见的由一堆大括号包裹的显式代码块,比如函数的函数体、for循环的循环体、if语句的某个分支等

宇宙(Universe)代码块

包代码块

文件代码块

每个if、for和switch语句均被视为位于其自己的隐式代码块中; • switch或select语句中的每个子句都被视为一个隐式代码块。

和switch-case无法在case子句中声明变量不同的是,select-case可以在case字句中通过短变量声明定义新变量

为break和continue增加后接label的可选能力;

增加type switch,让类型信息也可以作为分支选择的条件

增加针对channel通信的switch-case语句——select-case

所谓“快乐路径”即成功逻辑的代码执行路径

• 当出现错误时,快速返回; • 成功逻辑不要嵌入if-else语句中; • “快乐路径”的执行逻辑在代码布局上始终靠左,这样读者可以一眼看到该函数的正常逻辑流程; • “快乐路径”的返回值一般在函数最后一行,就像上面伪代码段1中的那样。

小心迭代变量的重用

参与循环的是range表达式的副本

切片在Go内部表示为一个结构体,由(*T, len, cap)三元组组成

表示切片副本的结构体中的*T依旧指向原切片对应的底层数组,因此对切片副本的修改也都会反映到底层数组a上

过for range对于string来说,每次循环的单位是一个rune,而不是一个byte,返回的第一个值为迭代字符码点的第一字节的位置

for range无法保证每次迭代的元素次序是一致的。同时,如果在循环的过程中对map进行修改,那么这样修改的结果是否会影响后续迭代过程也是不确定的

channel在Go运行时内部表示为一个channel描述符的指针(关于channel的内部表示将在后文中详细说明),因此channel的指针副本也指向原channel

当channel作为range表达式类型时,for range最终以阻塞读的方式阻塞在channel表达式上,即便是带缓冲的channel亦是如此:当channel中无数据时,for range也会阻塞在channel上,直到channel关闭。

Go语言规范中明确规定break语句(不接label的情况下)结束执行并跳出的是同一函数内break语句所在的最内层的for、switch或select的执行

在改进后的例子中,我们定义了一个label——loop,该label附在for循环的外面,指代for循环的执行。代码执行到“break loop”时,程序将停止label loop所指代的for循环的执行

带label的continue和break提升了Go语言的表达能力,可以让程序轻松拥有从深层循环中终止外层循环或跳转到外层循环继续执行的能力,使得Gopher无须为类似的逻辑设计复杂的程序结构或使用goto语句

在C语言中,case语句默认都是“fall through”的,于是就出现了每个case必然有break附在结尾的场景

在程序中使用fallthrough关键字前,先想想能否使用更为简洁、清晰的case表达式列表替代

◆ 第四部分 函数与方法

从程序逻辑结构角度来看,包(package)是Go程序逻辑封装的基本单元,每个包都可以理解为一个“自治”的、封装良好的、对外部暴露有限接口的基本单元

在Go包这一基本单元中分布着常量、包级变量、函数、类型和类型方法、接口等

Go语言中有两个特殊的函数:一个是main包中的main函数,它是所有Go可执行程序的入口函数;另一个就是包的init函数。 init函数是一个无参数、无返回值的函数

如果一个包定义了init函数,Go运行时会负责在该包初始化时调用它的init函数。在Go程序中我们不能显式调用init,否则会在编译期间报错

Go运行时不会并发调用init函数,它会等待一个init函数执行完毕并返回后再执行下一个init函数,且每个init函数在整个Go程序生命周期内仅会被执行一次

不要依赖init函数的执行次序。

Go运行时遵循“深度优先”原则

init函数就好比Go包真正投入使用之前的唯一“质检员”,负责对包内部以及暴露到外部的包级数据(主要是包级变量)的初始状态进行检查。在Go运行时和标准库中,我们能发现很多init检查包级变量的初始状态的例子

Go语言以“成为新一代系统级语言”而生,但在演进过程中,逐渐演变成了面向并发、契合现代硬件发展趋势的通用编程语言

Go语言中的方法(method)本质上是函数的一个变种

本质上,我们可以说Go程序就是一组函数的集合

如果一门编程语言对某种语言元素的创建和使用没有限制,我们可以像对待值(value)一样对待这种语法元素,那么我们就称这种语法元素是这门编程语言的“一等公民”

拥有“一等公民”待遇的语法元素可以存储在变量中,可以作为参数传递给函数,可以在函数内部创建并可以作为返回值从函数返回。在动态类型语言中,语言运行时还支持对“一等公民”类型的检查

正如Ward Cunningham对“一等公民”的诠释,Go中的函数可以像普通整型值那样被创建和使用

计算机科学中,柯里化是把接受多个参数的函数变换成接受一个单一参数(原函数的第一个参数)的函数,并返回接受余下的参数和返回结果的新函数的技术

闭包是在函数内部定义的匿名函数,并且允许该匿名函数访问定义它的外部函数的作用域

本质上,闭包是将函数内部和函数外部连接起来的桥梁。

函子需要满足两个条件: • 函子本身是一个容器类型,以Go语言为例,这个容器可以是切片、map甚至channel; • 该容器类型需要实现一个方法,该方法接受一个函数类型参数,并在容器的每个元素上应用那个函数,得到一个新函子,原函子容器内部的元素值不受影响。

尽管作为“一等公民”的函数给Go带来了强大的表达能力,但是如果选择了不适合的风格或者为了函数式而进行函数式编程,那么就会出现代码难于理解且代码执行效率不高的情况(CPS需要语言支持尾递归优化,但Go目前并不支持)

defer的第二个重要用途就是拦截panic,并按需要对panic进行处理,可以尝试从panic中恢复(这也是Go语言中唯一的从panic中恢复的手段)

对于自定义的函数或方法,defer可以给予无条件的支持,但是对于有返回值的自定义函数或方法,返回值会在deferred函数被调度执行的时候被自动丢弃

defer关键字后面的表达式是在将deferred函数注册到deferred函数栈的时候进行求值的。

defer让进行资源释放(如文件描述符、锁)的过程变得优雅很多,也不易出错。但在性能敏感的程序中,defer带来的性能负担也是Gopher必须知晓和权衡的

使用defer的函数的执行时间是没有使用defer的函数的7倍左右

在Go 1.14版本中,defer性能提升巨大,已经和不用defer的性能相差很小了

和函数相比,Go语言中的方法在声明形式上仅仅多了一个参数,Go称之为receiver参数。receiver参数是方法与类型之间的纽带

这种直接以类型名T调用方法的表达方式被称为方法表达式(Method Expression)。类型T只能调用T的方法集合(Method Set)中的方法

方法集合决定接口实现

我们首先要识别出自定义类型的方法集合和接口类型的方法集合

对于非接口类型的自定义类型T,其方法集合由所有receiver为T类型的方法组成

而类型T的方法集合则包含所有receiver为T和T类型的方法

Go的设计哲学之一是偏好组合,Go支持用组合的思想来实现一些面向对象领域经典的机制,比如继承。而具体的方式就是利用类型嵌入(type embedding)。

不过在Go 1.14之前的版本中这种方式有一个约束,那就是被嵌入的接口类型的方法集合不能有交集

在结构体类型中嵌入接口类型后,该结构体类型的方法集合中将包含被嵌入接口类型的方法集合

优先选择结构体自身实现的方法。

如果结构体自身并未实现,那么将查找结构体中的嵌入接口类型的方法集合中是否有该方法,如果有,则提升(promoted)为结构体的方法。

如果结构体嵌入了多个接口类型且这些接口类型的方法集合存在交集,那么Go编译器将报错,除非结构体自己实现了交集中的所有方法。

结构体类型在嵌入某接口类型的同时,也实现了这个接口

在结构体类型中嵌入结构体类型为Gopher提供了一种实现“继承”的手段

• T类型的方法集合 = T1的方法集合 + *T2的方法集合;

• T类型的方法集合 = T1的方法集合 + *T2的方法集合。

已有的类型(比如上面的I、T)被称为underlying类型,而新类型被称为defined类型。

基于接口类型创建的defined类型与原接口类型的方法集合是一致的

而基于自定义非接口类型创建的defined类型则并没有“继承”原类型的方法集合,新的defined类型的方法集合是空的。

方法集合决定接口实现。基于自定义非接口类型的defined类型的方法集合为空,这决定了即便原类型实现了某些接口,基于其创建的defined类型也没有“继承”这一隐式关联。新defined类型要想实现那些接口,仍需重新实现接口的所有方法。

Go预定义标识符rune、byte就是通过类型别名语法定义的: // $GOROOT/src/builtin/builtin.go
type byte = uint8
type rune = int32

类型别名与原类型拥有完全相同的方法集合,无论原类型是接口类型还是非接口类型。

虽然string类型变量可以直接赋值给interface{}类型变量,但是[]string类型变量并不能直接赋值给[]interface{}类型变量

Go语言不允许在同一个作用域下定义名字相同但函数原型不同的函数

如果要重载的函数的参数都是相同类型的,仅参数的个数是变化的,那么变长参数函数可以轻松对应;如果参数类型不同且个数可变,那么我们还要结合interface{}类型的特性。

如果参数在传入时有隐式要求的固定顺序(这点由调用者保证),我们还可以利用变长参数函数模拟实现函数的可选参数和默认参数

◆ 第五部分 接口

Go语言推崇面向组合编程,而接口是Go语言中实践组合编程的重要手段。

接口是Go这门静态类型语言中唯一“动静兼备”的语言特性。

接口类型变量具有静态类型

支持在编译阶段的类型检查:当一个接口类型变量被赋值时,编译器会检查右值的类型是否实现了该接口方法集合中的所有方法。

接口类型变量兼具动态类型,即在运行时存储在接口类型变量中的值的真实类型。

接口类型变量在程序运行时可以被赋值为不同的动态类型变量,从而支持运行时多态。

装箱(boxing)是编程语言领域的一个基础概念,一般是指把值类型转换成引用类型

在Go语言中,将任意类型赋值给一个接口类型变量都是装箱操作

了前面对接口类型变量内部表示的了解,我们知道接口类型的装箱实则就是创建一个eface或iface的过程

接口越大,抽象程度越低。 ——Rob Pike,Go语言之父

接口就是将对象的行为进行抽象而形成的契约。契约有繁有简,Go选择了去繁就简

契约的自动遵守:Go语言中接口与其实现者之间的关系是隐式的

实现者仅需实现接口方法集中的全部方法,便算是自动遵守了契约,实现了该接口

小契约:契约繁了便束缚了手脚,降低了灵活性,抑制了表现力。Go选择使用小契约,表现在代码上便是尽量定义小接口

接口越小,抽象程度越高,被接纳度越高

计算机程序本身就是对真实世界的抽象与再建构。抽象是对同类事物去除其个别的、次要的方面,抽取其相同的、主要的方面的方法

抽象程度越高,对应的集合空间越大;抽象程度越低(越具象,越接近事物的真实面貌),对应的集合空间越小

接口越小(接口方法少),抽象程度越高,对应的事物集合越大,即被事物接纳的程度越高。而这种情况的极限恰是无方法的空接口interface{},空接口的这个抽象对应的事物集合空间包含了Go语言世界的所有事物。

Go的设计原则推崇通过组合的方式构建程序

小接口更契合Go的组合思想,也更容易发挥出组合的威力

专注于接口是编写强大而灵活的Go代码的关键

越偏向业务层,抽象难度越高

有了接口后,我们就会看到接口被用在代码的各个地方。一段时间后,我们来分析哪些场合使用了接口的哪些方法,是否可以将这些场合使用的接口的方法提取出来放入一个新的小接口中,就像图27-6中的那样。 在图27-6中,大接口1定义了6个方法。一段时间后,我们发现方法1和方法2经常用在场合1中,方法3和方法4经常用在场合2中,方法5和方法6经常用在场合3中。这说明大接口1的方法呈现出一种按业务逻辑自然分组的状态。

空接口不提供任何信息。 ——Rob Pike,Go语言之父

与Java的严格约束和编译期检查不同,动态语言走向另一个“极端”:接口的实现者无须做任何显式的接口实现声明,Ruby解释器也不做任何检查

在函数或方法参数中使用空接口类型,意味着你没有为编译器提供关于传入实参数据的任何信息,因此,你将失去静态类型语言类型安全检查的保护屏障,你需要自己检查类似的错误,并且直到运行时才能发现此类错误。

建议广大Gopher尽可能抽象出带有一定行为契约的接口,并将其作为函数参数类型,尽量不要使用可以逃过编译器类型安全检查的空接口类型(interface{})。

仅在处理未知类型数据时使用空接口类型;

其他情况下,尽可能将你需要的行为抽象成带有方法的接口,并使用这样的非空接口类型作为函数或方法的参数

如果说C++和Java是关于类型层次结构和类型分类的语言,那么Go则是关于组合的语言。 ——Rob Pike,Go语言之父

“偏好组合,正交解耦”是Go语言的重要设计哲学之一。

正交性为“组合”哲学的落地提供了前提,而组合就像本条开头引用的Rob Pike的观点那样,是Go程序内各组件间的主要耦合方式,也是搭建Go程序静态结构的主要方式。

组合方式莫过于以下3种。 (1)通过嵌入接口构建接口

(2)通过嵌入接口构建结构体

(3)通过嵌入结构体构建新结构体

而通过接口进行水平组合的一种常见模式是使用接受接口类型参数的函数或方法。

 图29-1 以接口为连接点的水平组合的基本形式

包裹函数(wrapper function)的形式是这样的:它接受接口类型参数,并返回与其参数类型相同的返回值

通过包裹函数可以实现对输入数据的过滤、装饰、变换等操作,并将结果再次返回给调用者。

由于包裹函数的返回值类型与参数类型相同,因此我们可以将多个接受同一接口类型参数的包裹函数组合成一条链来调用

适配器函数类型(adapter function type)是一个辅助水平组合实现的“工具”类型

它可以将一个满足特定函数签名的普通函数显式转换成自身类型的实例,转换后的实例同时也是某个单方法接口类型的实现者

在上述例子中通过http.HandlerFunc这个适配器函数类型,可以将普通函数greetings快速转换为实现了http.Handler接口的类型。转换后,我们便可以将其实例用作实参,实现基于接口的组合了

中间件就是包裹函数和适配器函数类型结合的产物

所谓中间件(如logHandler、authHandler)本质上就是一个包裹函数(支持链式调用),但其内部利用了适配器函数类型(http.HandlerFunc)将一个普通函数(如例子中的几个匿名函数)转换为实现了http.Handler的类型的实例,并将其作为返回值返回。

单元测试是自包含和自运行的,运行时一般不会依赖外部资源(如外部数据库、外部邮件服务器等),并具备跨环境的可重复性(比如:既可以在开发人员的本地运行,也可以在持续集成环境中运行)。

接口本是契约,天然具有降低耦合的作用

◆ 第六部分 并发编程

并发不是并行,并发关乎结构,并行关乎执行。 ——Rob Pike,Go语言之父

goroutine相比传统操作系统线程而言具有如下优势。 1)资源占用小,每个goroutine的初始栈大小仅为2KB。 // $GOROOT/src/runtime/stack.go
const (
 …
 // Go代码使用的最小栈空间大小
 _StackMin = 2048
)

2)由Go运行时而不是操作系统调度,goroutine上下文切换代价较小。 3)语言原生支持:goroutine由go关键字接函数或方法创建,函数或方法返回即表示goroutine退出,开发体验更佳。 4)语言内置channel作为goroutine间通信原语,为并发设计提供强大支撑。

一条很显然的改进思路是让这些环节“同时”运行起来,就像流水线一样,这就是并发(见图31-5)。

并发在程序的设计和实现阶段,并行在程序的执行阶段。

发现了G-M模型的不足后,Dmitry Vyukov亲自操刀改进了goroutine调度器,在Go 1.1版本中实现了G-P-M调度模型和work stealing算法[1],这个模型一直沿用至今,

计算机科学领域的任何问题都可以通过增加一个间接的中间层来解决

不要通过共享内存来通信,而应该通过通信来共享内存。 ——Rob Pike,Go语言之父

Go始终推荐以CSP模型风格构建并发程序

• goroutine:对应CSP模型中的P,封装了数据的处理逻辑,是Go运行时调度的基本执行单元。 • channel:对应CSP模型中的输入/输出原语,用于goroutine之间的通信和同步。 • select:用于应对多路输入/输出,可以让goroutine同时协调处理多个channel操作。

goroutine的执行函数返回,即意味着goroutine退出

但一些常驻的后台服务程序可能会对goroutine有着优雅退出的要求

可以通过Go语言提供的sync.WaitGroup实现等待多个goroutine退出的模式

Go语言的channel有一个特性是,当使用close函数关闭channel时,所有阻塞到该channel上的goroutine都会得到通知

在上述代码里,将每次的left(剩余时间)传入下一个要执行的goroutine的Shutdown方法中。select同样使用这个left作为timeout的值(通过timer.Reset重新设置timer定时器周期)。对照ConcurrentShutdown,SequentialShutdown更简单,这里就不详细介绍了。

  1. 管道模式 很多Go初学者在初次看到Go提供的并发原语channel时,很容易联想到Unix/Linux平台上的管道机制。下面就是一条利用管道机制过滤出当前路径下以”.go”结尾的文件列表的命令: $ls -l|grep “.go” Unix/Linux的管道机制就是将前面程序的输出数据作为输入数据传递给后面的程序,比如:上面的命令就是将ls -l的结果数据通过管道传递给grep程序。 管道是Unix/Linux上一种典型的并发程序设计模式,也是Unix崇尚“组合”设计哲学的具体体现。Go中没有定义管道,但是具有深厚Unix文化背景的Go语言缔造者们显然借鉴了Unix的设计哲学,在Go中引入了channel这种并发原语,而channel原语使构建管道并发模式变得容易且自然,如图33-3所示。

case y, ok := <-c2: // 从channel c2接收数据,并根据ok值判断c2是否已经关闭

在上面的例子中,main goroutine创建了一组5个worker goroutine,这些goroutine启动后会阻塞在名为groupSignal的无缓冲channel上。main goroutine通过close(groupSignal)向所有worker goroutine广播“开始工作”的信号

func Increase() int {
 cter.Lock()
 defer cter.Unlock()
 cter.i++
 return cter.i
}

func main() {
 for i := 0; i < 10; i++ {
 go func(i int) {
 v := Increase()
 fmt.Printf("goroutine-%d: current counter value is %d\n", i, v)
 }(i)
 }
 time.Sleep(5 * time.Second)
} 下面是使用无缓冲channel替代锁后的实现: // chapter6/sources/go-channel-case-6.go
type counter struct {
 c chan int
 i int
}

var cter counter

func InitCounter() {
 cter = counter{
 c: make(chan int),

如果s是chan T类型,那么len(s)针对channel的类型不同,有如下两种语义: ◦ 当s为无缓冲channel时,len(s)总是返回0; ◦ 当s为带缓冲channel时,len(s)返回当前channel s中尚未被读取的元素个数。

select语句的default分支的语义是在其他分支均因通信未就绪而无法被选择的时候执行,这就为default分支赋予了一种“避免阻塞”的特性

面向CSP并发模型的channel原语和面向传统共享内存并发模型的sync包提供的原语已经足以满足Go语言应用并发设计中99.9%的并发同步需求了,而剩余那0.1%的需求,可以使用Go标准库提供的atomic包来实现。

原子操作由底层硬件直接提供支持,是一种硬件实现的指令级“事务”

atomic包更适合一些对性能十分敏感、并发量较大且读多写少的场合。

◆ 第七部分 错误处理

C++之父Bjarne Stroustrup曾说过:“世界上有两类编程语言,一类是总被人抱怨和诟病的,而另一类是无人使用的。”

Go语言设计者们选择了C语言家族的经典错误机制:错误就是值,而错误处理就是基于值比较后的决策

错误是值,只是以error接口变量的形式统一呈现(按惯例,函数或方法通常将error类型返回值放在返回值列表的末尾)

Go 1.13及后续版本中,当我们在格式化字符串中使用%w时,fmt.Errorf返回的错误值的底层类型为fmt.wrapError

与errorString相比,wrapError多实现了Unwrap方法,这使得被wrapError类型包装的错误值在包装错误链中被检视(inspect)到

标准库中的net包就定义了一种携带额外错误上下文的错误类型

代码所在栈帧越低(越接近于main函数栈帧),if err != nil就越不常见;反之,代码在栈中的位置越高(更接近于网络I/O操作或操作系统API调用),if err != nil就越常见

panic和recover让函数调用的性能降低了约90%

Go提供了panic专门用于处理异常,而我们建议不要使用panic进行正常的错误处理

  1. 充当断言角色,提示潜在bug

针对每个连接,http包都会启动一个单独的goroutine运行用户传入的handler函数

39.3 理解panic的输出信息 由前面的描述可以知道,在Go标准库中,大多数panic是充当类似断言的作用的。每次因panic导致程序崩溃后,程序都会输出大量信息,这些信息可以辅助程序员快速定位bug。那么如何理解这些信息呢?这里我们通过一个真实发生的例子中输出的panic信息来说明一下。 下面是某程序发生panic时真实输出的异常信息摘录: panic: runtime error: invalid memory address or nil pointer dereference
[signal SIGSEGV: segmentation violation code=0x1 addr=0x0 pc=0x8ca449]

goroutine 266900 [running]:
pkg.tonybai.com/smspush/vendor/github.com/bigwhite/gocmpp.(*Client).Connect(0xc42040c7f0, 0xc4203d29c0, 0x11, 0xc420423256, 0x6, 0xc420423260, 0x8, 0x37e11d600, 0x0, 0x0)
 /root/.go/src/pkg.tonybai.com/smspush/vendor/github.com/bigwhite/gocmpp/client.go:79 +0x239
pkg.tonybai.com/smspush/pkg/pushd/pusher.cmpp2Login(0xc4203d29c0, 0x11, 0xc420423256, 0x6, 0xc420423260, 0x8, 0x37e11d600, 0xc4203d29c0, 0x11, 0x73)
 /root/.go/src/pkg.tonybai.com/smspush/pkg/pushd/pusher/cmpp2_handler.go:25 +0x9a
pkg.tonybai.com/smspush/pkg/pushd/pusher.newCMPP2Loop(0xc42071f800, 0x4, 0xaaecd8)
 /root/.go/src/pkg.tonybai.com/smspush/pkg/pushd/pusher/cmpp2_handler.go:65 +0x226

Linux (Debian 系) 安装官方微信 (Electron,非 wine 版)

使用 Linux 作为唯一主力系统的阻力之一,就来自于微信。

微信大概是目前大多数人都无法离开的软件,而在 Linux 下安装微信在此前是比较复杂的,这对于使用 Linux 工作生活存在一些障碍。

最近才发现微信有推出基于 Electron.js 的一款桌面程序,不需要依赖 Wine 那复杂和冗余的依赖,只需要装一个稍微“大”一点的 deb 包就可以。

而且因为是基于 deb,理论来说 debian 系操作系统,如 Ubuntu、Kali 等都是可以直接安装的。

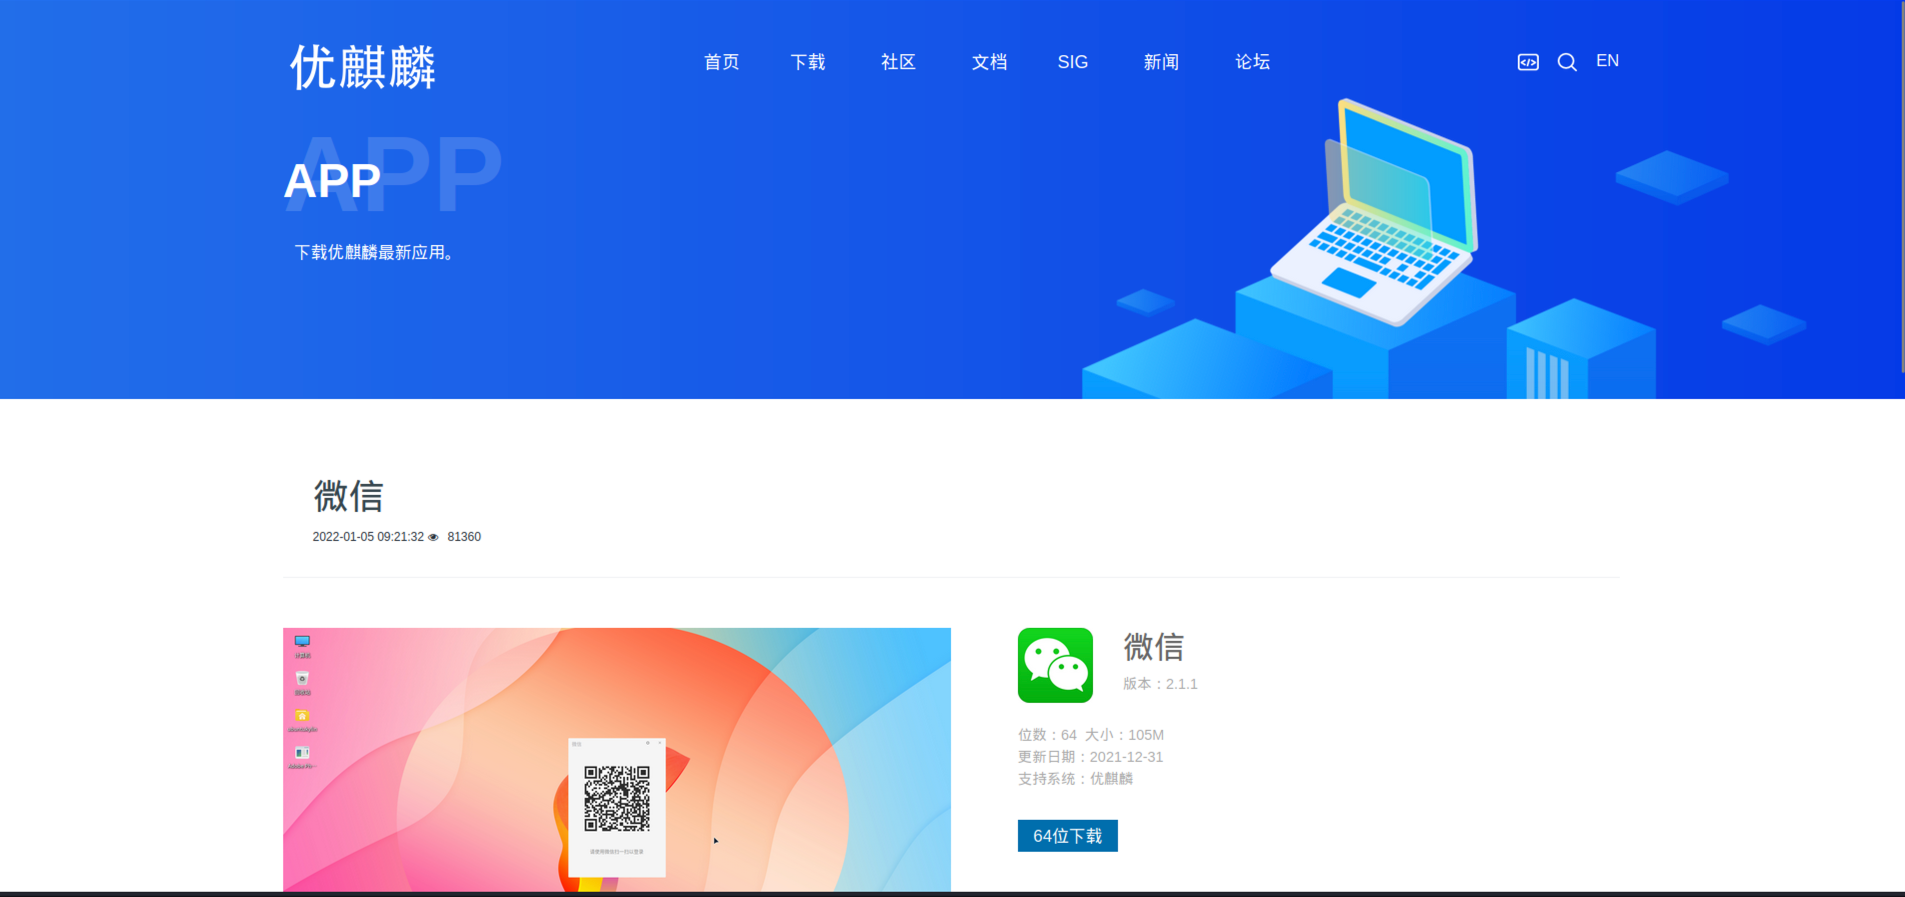
软件可以从优麒麟官网的软件下载页面找到:

https://www.ubuntukylin.com/applications/106-cn.html

在这个页面直接下载就可以,不要在其他陌生的地方下载。

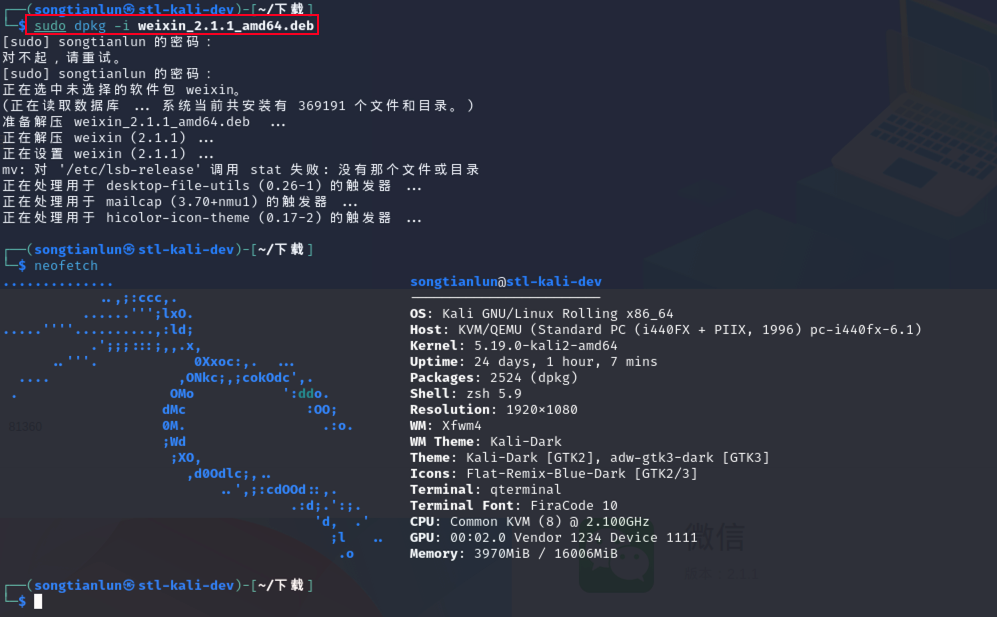
下载下来之后看一下,一个平平无奇的 deb 软件包, debian 系操作系统直接 dpkg -i xx.deb 安装即可,基本不会出现依赖问题。

实测在 kali 下正常使用。安装完成,就可以在软件清单找到微信了,直接打开即可,扫码登录即可使用。

不要抱有太高期待,现阶段只是能用。不过这对于大部分会考虑使用 linux 做主系统的人们来说,应该是够用了。

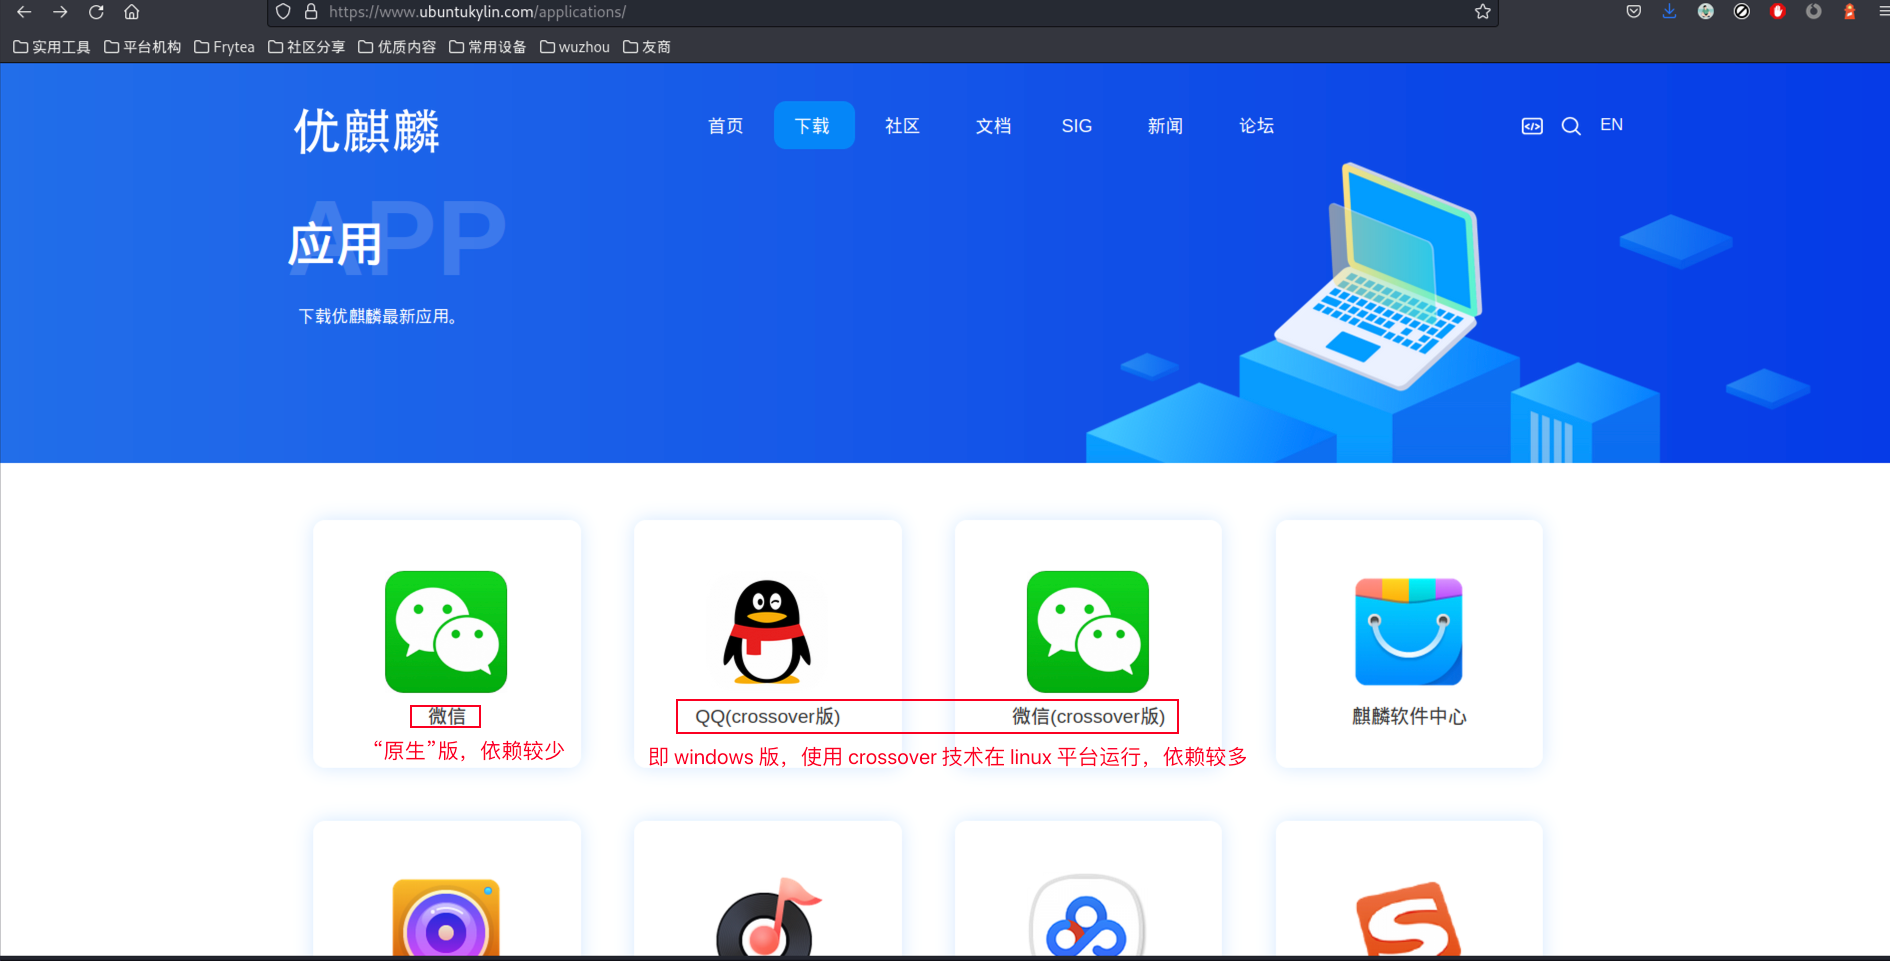
实际上在优麒麟官网还可以找到其他一些常用软件,可以看到 QQ 和微信还有提供一种 crosscover 版,也就是基于 wine 的,在 linux 运行 windows 的方式运行,这种方式也许功能会多一些,但依赖实在太多,配置复杂,用起来很繁琐,不推荐使用。

总结一下,当前国产操作系统发展越来越好,虽然与 windows、macos 的差距还很大,而且对于底层技术的掌控也比较有限,但这是一个很好的趋势,提升自己在 linux 下的工作能力,对于技术人员或是工作离不开计算机的人们来说,长期来看很有益处。

另外,在 linux 下几乎可实现所有想要的功能,相对 windows 或 macos 的直接使用,可以在这一过程中获得更多成就感。

参考文献

关于新时代“电子毒品”的思考

这世上有这么一群人,“不装抖音”是他们最后的倔强。

我恰好就属于这群人的一员。

人活在世上多么不容易,辛苦产生一些价值,片刻的闲暇还是难逃“收割”的命运。

在没有新时代这些诱惑,如电子游戏、短视频之前,那些有害的东西都是比较显而易见的,但凡是头脑清晰都能够有所分辨。

那些没有任何代价就能够令人开心的东西,一定有所玄机。

一切诈骗、营销,几乎都是利用人们“不劳而获”的原始行为。

即使大多数人都知道不可能“不劳而获“,但还是免不了尝试一下,特别是尝试成本很低的时候。

假如尝试一次只要几块钱,就更难以分辨了。

这些东西的出现,从某种角度来看,其实是将人与人之间的距离进一步拉大了。

更多、更隐晦的诱惑之下,对人的自制力是前所未有的考验。能够经受住考验的人就可以不断进步,反之不一定。

另一方面,大量新时代工具的出现,如最近的 chatGPT,可以用 AI 帮我们做表格,写文章,甚至写代码,写方案。

如此一来,大量重复性工作再也不需要人来做,那些知识面广的精英,更容易利用 AI 提升自己的效率,将自己的注意力用在思考更复杂的问题之上。

而知识面不够广的人,则难逃被 AI 的命运,比如 AI 创作出的问题看不到,出问题无从查证。

可见,人与人之间的差距随着时代的进步,会被不断的拉开。

而我们能做的,就是 不忘初心,不断进步。

一方面,不要忘记做人最根本最珍贵的东西。另一方面,不断积累,让自己向精英靠近。

时代的进步,给人更多的选择,同时给人们提出更高的要求。是选择拥抱新时代,还是静候传统,这是自己的选择。

一切的基础,还是那句,不忘初心。