《大脑通信员:认识你的神经递质》阅读笔记

读完了赵思家的《大脑通信员:认识你的神经递质》,对于大脑中的神经递质有了初步的认知,才发现之前对多巴胺、去甲肾上腺素等等的认知是存在偏差,对于大脑的工作原理有了深一步的认知,下面是阅读摘录。

前言

初步了解大脑中的常见神经递质。

◆ 最常见的神经递质有七种:多巴胺、血清素、去甲肾上腺素、乙酰胆碱、谷氨酸、GABA(γ-氨基丁酸)和内啡肽。

01 哦,是爱情的味道:大脑里的化学反应

◆ 肾上腺素决定出不出手,多巴胺决定天长地久,5-羟色胺决定谁先开口,端粒酶决定谁会先走

◆ 去甲肾上腺素和冲动、觉醒有关

◆ 爱和多巴胺并非因果关系,所以打着“只有热恋时才有多巴胺,而多巴胺只能维持三个月”的旗号来解释自己没感觉的都是没文化的渣男渣女

◆ 血清素有让人冷静、放松的效果,在热恋状态下,大脑中血清素含量较低

◆ 端粒酶决定了人的生命长度

◆ 爱情和快乐是两个相互独立的概念

◆ 神经科学家做的很多工作,实际上就是在给这个世界“去浪漫化”

◆ All’s Well That Ends Well是英国戏剧家莎士比亚的一部爱情喜剧的剧名。梁实秋将它翻译为“终成眷属”,其实它的直译意思是:结局好,一切都好。

02 大脑里的信使

◆ ,想要学得又快又好,就不能让知识点里有漏洞

大脑里的打工人

◆ 这些小部件各有作用,通过各式各样的化学反应相互影响相互牵制,同时生产和破坏着其他各式各样的小部件,像是个小社会一样,将整个社会维持在一个最优的平衡状态,进而从外界获得能量,甚至将整个社会1:1地复制繁殖

◆ 神经信号沿着轴突传递到轴突末端,然后通过突触传递到其他的神经细胞

◆ 这些在细胞里发生的各式各样的化学反应,叫作新陈代谢(metabolism)

◆ 因为它是一个不间断的能量与物质的交换过程,一旦这个交换过程停止,生命就结束了,所以新陈代谢的英语名来自希腊语里的“改变”

多巴胺的三大功能

◆ 多巴胺控制着行为选择的门槛高低

◆ 如果基底核发起了一个行动A,并且行动之后多巴胺水平升高了,中脑皮层通路就会做出相应改变,使得下一次遇到类似的环境或场景时,更倾向于选择行动A

◆ 正因为这条通路负责控制激励显著性,所以这条通路上的多巴胺有个特别重要的任务,就是强化学习(reinforcement learning)

◆ 惩罚导致行为的减少,而强化导致行为的增加

多巴胺过多有什么不好?

◆ 如果习惯了错误的行为,就成了瘾

◆ 准确地说,瘾是指一种重复性的强迫行为,即使知道这种行为会有不好的影响,也难以停止,就像是产生了一种依赖,

◆ 基底核的英文名是“basal ganglia”

多巴胺不是真正的快乐

◆ 多巴胺只是一个半成品,完成品是去甲肾上腺素

多巴胺究竟是什么?

◆ 因为多巴胺不是奖励的绝对值,而是奖励预测误差(reward prediction error)[插图]。

◆ 这就是为什么在多巴胺的奖励机制中,不得不提的就是“预测”这一环节

◆ 奖励预测误差

◆ 满足感并非来自奖赏的绝对值,而在于被奖励的意外感

◆ 奖励作用有一个必要条件,那就是行为参与(behavioural engagement)

◆ 人会对小概率事件产生“它很常见”的错觉,这就更导致基线不成比例地提高

◆ 1.“多巴胺是奖励预测误差”这一概念的奠基性论文,截至2019年9月22日已经被引用了7440次。Schultz, W.,Dayan, P., & Montague, P. R. (1997). A neural substrate of prediction and reward. Science, 275(5306), 15931599.2.知友Mon1st在知乎专栏上发过一篇非常好的文章,若是你对多巴胺的计算神经科学的机制感兴趣,可以去看看:《唱唱反调:多巴胺=快乐?没那么简单!》https://zhuanlan.zhihu.com/p/218034903.知友大哉问也曾发过一篇相关的专栏,很全面,知识很硬核:《多巴胺奖赏预测误差》https://zhuanlan.zhihu.com/p/24643394

解忧杂货铺

◆ 绝大多数人并非在寻求无中生有的那种快乐感,而是想从日常消极的情绪中挣脱出来,希望自己离开不快乐的状态。换言之,就是对自己的情绪有自主权

◆ 虽然血清素不生产快乐感本身,但它控制了能不能感受到快乐的那个闸门

睡意正浓

◆ 中缝核是一个非常古老的脑区,说它古老是指,连鱼——这种说是我们的远方亲戚都太牵强的生物——都有中缝核

◆ 正是因为血清素管的是睡意的产生,所以它起作用的时间点应该是在睡前而不是睡眠中

◆ 大脑里有两个控制睡眠的系统。一个是昼夜节律(也就是生物钟):当有光照时,身体会苏醒;当天黑时,身体知道该睡觉了。另一个是睡眠压力:早晨起床后,因为你已经得到了休息,所以会觉得充满干劲;但如果一直没睡,睡眠压力就会随着缺少睡眠的时间而累积,你会变得疲惫和困倦,如果你一晚上没睡,那睡眠压力会特别高,即使外面天亮了,生物钟告诉你该醒了,你还是会觉得特别累。这两者协调一致,才能保证良好的睡眠

◆ 血清素可能就是睡眠压力的指标

◆ 你醒着的时候,血清素就像是时间沙漏一样,开始逐渐堆起来,堆得越多,睡眠压力越高,你就越想睡觉——无论是白天还是黑夜

◆ 当生产血清素的中缝核被关掉,你就不会有睡眠压力,只有生物钟,自然就睡得少了

◆ 血清素不能通过血脑屏障,所以直接吃血清素,并不能提高大脑里的血清素含量,不能够抗焦虑或是安眠。市场上销售的这类营养剂,从效益上看只是安慰剂

减肥不成功,你是不是“杜绝碳水化合物”了?

◆ “You are what you eat.”是一句英语谚语,意思是人如其食,饮食可以反映出一个人的健康状态和生活环境

◆ 当时最主要的教材,叫作《神经科学:探索脑》(Neuroscience: Exploring the Brain)。这可能是对神经科学初学者最友好的一本入门级教材了

◆ 低碳水化合物甚至是无碳水化合物,可能确实对减少热量摄入有显著帮助,但从对大脑的影响的角度来讲,不一定是好事。这个关键就在于血清素

◆ 血清素在大脑里的生产速度是几乎完全被一个叫作色氨酸(tryptophan)的东西控制的

◆ 大脑中的色氨酸越多,血清素就会越多;色氨酸越少,血清素越少

◆ 我们日常食物中色氨酸含量最高的是猪肉、鸡肉、豆制品和一些海鱼

◆ 虽然刚吃完高蛋白食物时,血液里的色氨酸含量确实会迅速升高,但接下来好几个小时里,大脑中的血清素含量却会降低

◆ 决定大脑里的色氨酸含量的不仅是身体血液中的色氨酸含量,还有其他氨基酸的含量

◆ 从身体进入大脑,氨基酸需要通过血脑屏障。而血脑屏障不是一个你想过就能过的地方,氨基酸会相互竞争,这种竞争导致能进入大脑的色氨酸反而减少了

◆ 血脑屏障是什么?它是血液和脑组织之间的一道屏障

◆ 虽然神经细胞也需要氧气,而且需求量最大,但神经细胞是不可直接接触血液的

◆ 中风就是大脑中血管破裂,血液和神经细胞直接接触,导致了神经细胞的损伤和死亡

◆ 这个屏障就像是一个非常细的筛子,只让特定的物质,譬如说氧气、二氧化碳、血糖通过。大部分的药物或病菌因体积太大,都是不能通过的

◆ 那到底要怎么吃才能提高大脑里的血清素含量呢?答案是,在吃高蛋白食物的同时也要吃高碳水化合物食物

◆ 胰腺注意到血液中碳水化合物含量高时,会立即生产胰岛素(就是糖尿病患者缺的那个东西)。而胰岛素就能作用在氨基酸上,减少其他氨基酸,而不影响色氨酸,这样“色氨酸:氨基酸”的比例就变大了,色氨酸自然能够有效地进入大脑,提高血清素的生产量。这可能是为什么当大脑里的色氨酸含量过低时(也就是忧伤时),可能出现“特别想吃高碳水化合物食物”的冲动。

◆ 由此可见,“杜绝碳水化合物”的极端饮食结构可能反而不能减肥,因为完全没有碳水化合物可能会导致色氨酸不被大脑有效吸收,进而导致焦虑、失眠和“特别想吃碳水化合物”的冲动——我把这三个东西叫作“血清素缺乏三件套”。就算短期内“忍辱负重”,体重减下来了,我也不相信这三件套真能让人一直瘦

◆ 作为神经递质,大脑里的血清素的功能非常重要,最近几十年也被翻来覆去地研究。但有意思的是,人体内95%的血清素其实是在身体里生产的,这说明血清素在身体里很有可能有重要且独立的功能,但这种可能一直都被科学家们所忽视,直到近两年才引起注意

◆ 1.Yaakov Liu写过一篇特别硬核的血清素的科普文章:《五羟色胺的功能是什么》https://zhuanlan.zhihu.com/p/38346602

◆ 2.相比多巴胺,我们对血清素的了解其实还很浅。从计算神经科学的角度来看,多巴胺是奖励预测误差,这是彼得·达扬提出的一个概念,他也因此在2017年得到了神经科学领域里的大奖。在此之后,他进一步探索了大脑是如何对“惩罚”做出反应的,而他认为血清素可能和惩罚有关

◆ 与多巴胺相对,血清素有可能是惩罚预测误差,工作逻辑可能和多巴胺类似

◆ 要特别说明的是,这里说的“惩罚”并不一定是那种做错事所受到的惩罚,而是泛指“令人不愉悦的刺激或反应”。对“血清素是惩罚预测误差”这个理论感兴趣的小伙伴可以参考这篇论文:Cohen, J.Y., Amoroso,M.W., & Uchida, N. (2015). Serotonergic neurons signal reward and punishment on multiple timescales.ELife,4,e06346.

05 去甲肾上腺素

◆ 大脑里的主要是去甲肾上腺素,而躯干里的主要是肾上腺素。

◆ 我跟多巴胺关系也很密切。别看我们功能似乎差很远,其实我就是多巴胺变装而来的

和肾上腺素不得不说的关系

◆ 大脑里的主要是去甲肾上腺素,而躯干里的主要是肾上腺素

◆ 对我们普通人类来说,肾上腺素是把双刃剑。注射肾上腺素并不能让人爆发“洪荒之力”;相反,误用过量肾上腺素,会使人出现恶心、胸痛、血压升高、心跳过速等症状,甚至死亡。

为什么去甲肾上腺素会有两个不同的英语名字?

◆ 其实如果你坐直,把手绕到背上去摸,大概在腰和胸之间的位置就是肾上腺的大致所在。

状态不好,撤退!

◆ 去甲肾上腺素负责的是优化任务表现

◆ 随着觉醒程度的升高,人越来越警醒,越来越有精神,任务表现也越好,到达最优状态(曲线的最高点)。但一旦觉醒程度超过这个点,人就会变得焦虑,容易被分散注意力,导致当下所做的任务的表现变差(曲线的右侧)。

◆ 耶基斯–多德森定律:解释觉醒程度和行为表现的关系的心理学定律。如图所示,只有觉醒程度处于中央的位置时,才会有最好的行为表现。过低的觉醒程度会导致疲惫和睡眠,而过高的觉醒程度则会导致焦虑和分心。

去甲肾上腺素是怎么控制觉醒状态的呢?

◆ 负责生产去甲肾上腺素的蓝斑核跟负责控制瞳孔大小的肌肉有神经联系,当蓝斑核里的神经细胞激活的时候,瞳孔会放大。

◆ 换言之,当你感到疲倦的时候,瞳孔会比较小;当你过于兴奋的时候,瞳孔会特别大;当你专心致志的时候,瞳孔则会处于中等大小;而一旦出现什么令你警觉的刺激,你的瞳孔会快速放大然后缩小——这在学术上叫作瞳孔放大反应

去甲肾上腺素究竟是什么?

◆ 多巴胺是奖励的意外性,血清素是惩罚的意外性,而去甲肾上腺素是信息的意外性

不能不说的尼古丁

◆ 在吸烟者的神经细胞上,乙酰胆碱受体的数量要比一般人多得多,大部分与尼古丁相结合,剩下的与乙酰胆碱结合的受体的数量才和一般人的差不多

用“恶魔的呼吸”来控制他人

◆ 大剂量的东莨菪碱虽然不能剥夺人的自由意志,但却可以让人昏沉。在20世纪初,它还曾被用来当作吐真剂(瞬间切入《哈利·波特与火焰杯》的场景),但完全没有斯内普配的药剂那么靠谱,因为它只是让人变得话多,并不能确保说的都是真的,还不如二两二锅头来得经济实惠

◆ 提东莨菪碱的主要原因是,它其实是一种乙酰胆碱的抑制剂,会让人失去学习新信息的能力

◆ 2019年夏天播出的缉毒刑侦电视剧《破冰行动》中曾出现用东莨菪碱来杀人的剧情

◆ 乙酰胆碱控制了信息流,从而直接影响相关记忆的形成

◆ 当你醒着的时候,高浓度的乙酰胆碱帮助感知信号转化为记忆;当你刚入睡,进入慢波睡眠的时候,乙酰胆碱浓度变低;当你进入快速眼动睡眠期的时候,开始巩固今天一天的记忆,所以乙酰胆碱浓度又升高了

你真的了解阿尔茨海默病吗?

◆ AD的一个最有名的特点就是生产乙酰胆碱的神经细胞大片死亡或者活跃性降低

乙酰胆碱究竟是什么?

◆ 神经病学(neurology)是医学的一个分支,专门应付神经系统的疾病(有神经内科学和神经外科学两个分支)。作为应用科学的一种,其与神经外科均有别于隶属自然科学的神经科学。前者负责在患者身上运用已有知识,而后者则专门研究与发现新的科学概念。

大脑的“阴”

◆ 中医常用“风”来形容突发性疾病,比如老人脑出血,叫“中风”,儿童突然失去意识,双眼上翻不停抽动,叫“抽风”,而癫痫又被叫作“羊角风

◆ 如果父母常拍打孩子的头部,使得颅内出血,也会导致孩子患上癫痫。

借酒消愁:为什么微醺时人感到放松?

◆ 虽然作用于GABA受体的药物都有抗焦虑、让人放松的效果,但不要高兴得太早,它们也有损害认知和记忆力的副作用,所以要慎用

为什么运动后会感到很爽?

◆ 简言之,高运动量会减少糖原,而糖原减少会导致内啡肽升高[插图],进而给人带来快乐。

10 一花独放不是春——睡眠

◆ [插图]宜家2020年9月广告海报。我最喜欢的创意是最右侧的“Sleep”面霜。Creative: Mother; Production company: The Miss Jones Agency; Photographer: Amy Currell; Stylist: Amy Friend; Modelmaking: Andy Knight L

“坐白班”的神经递质

◆ 控制“醒”的神经递质主要有三种:去甲肾上腺素、血清素和组胺。

得丘脑者,得睡眠

◆ 简而言之,控制丘脑,就能控制对外界的感知,如果我们一直对外界保持警醒,就不可能睡着。换言之,得丘脑者,得睡眠。

◆ 常常想,从古至今,我们不断在寻求一个能够解释宇宙间种种现象的答案,这种行为是不是就是一种寻求故事的过程呢

后记

读完这本书,对于多巴胺、去甲肾上腺素、睡眠、乙酰胆碱、东莨菪碱、血清素等等神经递质有了初步的认知,这些神经递质分布在大脑各处,维持着整个人体的平衡。如果这些神经递质紊乱,就会出现各种奇怪的问题。因此保持一个良好的作息,维持身体各项水平平衡是很重要的。

不要去打破身体的平衡,要帮助这些神经递质更好的作用,维持身体的规律平衡。另一方面也要有信心,这些神经递质的作用机制本质上是人类繁衍进步的产物,是为了让人们应对复杂的外部环境,求生,而产生的,因此要相信自己足够强大。研究其背后的左右机制,也可以窥探到许多人类繁衍进步的历史,很有意思。

一直想读一些大脑原理相关的书籍,深入了解人脑作用机制,就从这本书开始,继续探索吧。

腾讯云技术架构联盟活动笔记——“云峰论剑” 聊聊当前的前沿研究/产品/实践案例

“云峰论剑” 聊聊当前的前沿研究/产品/实践案例

腾讯云架构同盟活动,以下是我参加本次活动的笔记。活动收获很多,听取不同角度的人们做的事情,带给我许多启发。在现场,参加这种线下活动,感觉特别好,这种感觉比线上参加完全比不了。下面把我参加活动的笔记分享出来,没有做排版优化,都是原始记录,内容均来自现场老师分享材料,如有侵权请联系我删除。

张智 出品人,朗毅科技 EVP & CIO

《微计算:一种微小代价的高效率人工智能方法》

黄翰 中山大学教授

人工智能的第一性是什么?

人类的第一性是本体性,第二性是功能性; 而人工智能的第一性是功能性。

人工智能的本质是知识的表示,简单来说就是把知识编码到计算机中。

工业文明决定了人工智能的发展。

实验室做大才好发论文。大力出奇迹,很多人喜欢做。

实现高效率算法的四个层次

  1. 智商:算法设计
  2. 人力:程序实现
  3. 方案:并行计算
  4. 金钱:升级设备

高效率算法设计的要领——“省”。省区多余和重复的计算量。

微计算方法:微搜索 + 微计算

进化算法是一种人工智能方法。

知识表示的形式:随机遍历与贪心方法

微搜索算法设计举例:多约束多目标优化;

应用研究:

  1. 基于微搜索的精确抠图算法;答题卡自动评分;
  2. 基于微搜索的双层次车辆路径问题高效求解
  3. 柔性作业车间生产调度
  4. ATCG-PC 问题的微搜索算法求解
  5. 软件智能测试服务
  6. 微小数据量的图像训练样本集
  7. 标一得万的医学图像自动增广软件
  8. 微学习方法构建高价值数据库
  9. 微小代价的神经网络结构搜索
  10. 微小代价的聚类结构生成

研究主题: 1.微计算

  1. 微计算方法赋能具身智能
  2. 生化计算机赋能数字生命工程

黄教授个人兴趣:

  1. 解决 AI 应用技术难题
  2. AI 科普与创作

《从个人记忆到团队资产:Agent Memory 的进化与开源之路》

黄依琳

问题背景

能力在增长,经验没有继承。

演进过程

真正丢失的是历史判断中的“为什么”。

个人记忆解决连续,团队记忆解决继承。

四类资产

  • Chat Memory
  • LLM-Wiki
  • CodeGraph
  • Skill

《恶劣条件下小目标检测的模型优化与实践》

李中华 中山大学,副教授,智能工程学院

研究背景

恶劣条件的多维度图谱

核心矛盾三角:精度、速度、鲁棒性

小目标检测方法演进脉络

  • 两阶段方法:Faster R-cnn 系列
  • 单阶段方法:YOLO /SSD 系列
  • Anchor-free 方法:FCOS /TOOD

恶劣条件鲁棒性检测的两条技术路线

  • 路线一:图像预处理增强
  • 路线二:网络端到端鲁棒性

开放词汇大模型带来的范式转移

  • 传统:封闭集检测
  • 现在:开放词汇检测

模型优化的四层框架纵览

  • 部署层
  • 范式层
  • 网络层
  • 数据层

数据层:恶劣条件下的数据构建策略

  • 真实采集+物理引导合成
  • 缺陷热力统计指导采样
  • 半监督增量自进化

网络层:轻量骨干与特征增强

  • 轻量化骨干设计
  • 多尺度特征融合
  • IA-FEM 特征增强模块

部署层:边缘优化与人机协同兜底

  • 模型压缩与边缘部署
  • 人机协同闭环
  • 在线自进化闭环

核心模块:IA-FEM 特征增强

实践:

  • 智能制造质检:级联框架中的推理路由与业务处置

关键技术:围观表象三步法提示词工程

  • 四维观察
  • 表象描述
  • 多粒度提炼

PCB 缺陷检测:残铜零样本捕获

  • 智能分流放行(硬实时算力节能)
  • 突发
  • 人工协同兜底

焊缝缺陷检测:量化效果与实证

  • 智能分流放行(保障高速节拍)
  • 一场靶向探针(零样本捕获新缺陷)
  • 人机协同复核(极端安全兜底)

质监系统的监控、复核与更新闭环

  • 运行监控:延迟、吞吐、置信度
  • 异常分流:超时、低置信度样本
  • 人工复核:确认标签与业务处置
  • 受控更新:评估、灰度、回退

四大维度的通用新范式

  • 维度一:开放词汇世界模型底座
  • 维度二:启发式两阶段级连路由
  • 维度三:微观表象三步法工程范式
  • 维度四:防遗忘增量自进化闭环

未来研究方向

  1. 统一恶劣条件建模
  2. 小目标超分辨率与检测一体化
  3. 端侧大模型:更小更快的开放词汇检测器
  4. 数字孪生驱动的合成数据闭环

《从单卡算力到系统价值:AI 推理架构的异构协同与实践》

张晶 / AMD

AI 推理架构的异构协同与实践

来自真实客户案例的 know-how:从成本约束、24GB OOM 到 CPU-GPU 工作负载重构

架构设计从约束开始

需求与验收标准:

  • CAPEX / 采购成本
  • Supply / 交付窗口
  • Memory / 可用容量
  • Latency / 吞吐
  • Quality / 质量
  • TCO / 单位产出

从单 GPU 到异构协同。

  • 32GB GPU Only:采购风险
  • 24GB GPU Only:运行时 OOM
  • CPU + GPU:验证峰值显存/时延/质量

如何定位OOM:先复现失败,再隔离峰值显存贡献

茶余饭后 #1

突发奇想,是不是可以撰写一个我个人的类似《青年文摘》的专刊,每天将自己看过有感悟的文字、链接之类的记录下来。记录下此时此刻的感受,以前也想做类似的事情,但总感觉自己阅历不够、水平不够,很多东西可能其他人早就看过了,没什么价值。但是现在越来越多的看到一些自己熟悉的东西,一些东西就算看过,每个人都有不同的视角。另一个角度看,同样的东西在不同阶段提起,也会有不同的感受。我们需要这样的契机,来反复体会“经典”的力量。

所以就有了这专刊《茶余饭后》,我会在自己的日记软件 Diarum 中记录自己看过有感触的一些内容,然后将这些内容简单整理后发布,希望能留下一些属于自己对世界的理解。

《科技爱好者周刊(第 417 期):不要让 AI 代表你》

refs: https://www.ruanyifeng.com/blog/2026/10/weekly-issue-417.html

(1)不要让 AI 代表你

不要让 AI 代表你,原因很简单。因为 AI 的行为模式是循环尝试,会穷尽所有可能的方式,尝试完成你交给它的任务,而且这样一遍遍的尝试,对 AI 来说几乎不产生成本。

但是,人类的社会系统是为人设计的,不是为 AI 这种行为模型设计的。如果大量的人授权 AI 代表自己行事,社会运作将瘫痪,因为人力无法处理 AI 发起的海量请求,最终只能让 AI 去对付 AI。

到了那个时候,你再想找真人来帮你解决问题,就不可能了。

但是总感觉,这是一个必然的路。未来必然越来越找到真人。有点悲观主义。

但是这或许是一个好的习惯,分辨一个人又多了一个维度,即 AI 度。

《为什么核潜艇导航几乎不用 GPS?》

refs: https://mp.weixin.qq.com/s/vI2yz3RaH-XYA2wYyBmFnQ

看这篇文章实在太有体会了。

对于外部设施的依赖,造就了当前这个繁荣的市场。但这种外部依赖是脆弱的。

许多时候,本着先把东西做出来,再优化的态度。但是当东西做出来了,这个东西也不值得再去优化了。这就是很多时候的现实。或许从一开始,就注定是这个结局。不是所有事情,都值得从一开始就认真对待;更不是所有事情,都值得在后面反复迭代。这其中的差异,取决于很多东西。

看这篇文章特别有感触,对于核潜艇这种战略武器,需要考虑最极端情况下的表现。因此就不能依赖 GPS/GNSS 这种现代化的简单方案,必须有一套完全依赖自身的强大基础设施。

我自己在编写程序的时候会很深刻的思考这个问题。很多时候一个架构决策,决定了后期相差数倍的运营成本、维护成本还有风险成本。为了降低成本和风险,我更多时候倾向于自给自足,尽可能减少外部依赖,尽可能依赖可控可靠的基础设施。在这中间我会比大部分人思考更多问题,而这些问题几乎是极少数人才能理解的。

这个公众号归属地还是郑州,我呆了快6年的地方,感情深厚的土地。

《37岁才明白的事》

refs: https://mp.weixin.qq.com/s/eZ4Btny9ZFVL_gACyoxaZw

看这篇文章有好几点感悟:

(1)“像投资一样小心花费注意力,像吃霸王餐一样挥霍自己的表达欲”。

这段话很有感悟。我是一个表达欲时而丰富时而匮乏的人。比如现在这个时刻会很想写点什么,所以看到这段话就超级有感悟。就像吃饭一样,有时候饿了,有时候不饿。饿了,就可以让自己饱餐一顿,吃饱饭才是正事。不饿的时候,就少吃一些,不要让自己饿的不行就好了。所以,在想写东西的时候,就大大方方写下来吧。

因为职场的缘故,我在刻意减少自己写出的东西。因为之前经历过一次或许不是很合适的面试,聊了一个多小时,然后找了一个很小的点否掉了全部。下来我就觉得很奇怪,如果真不想招人,花这么久时间做什么呢。如果想招人,就因为一个小知识点没回答上来就否掉,也有点奇怪了。不管这么多了。但是这位面试官说把我简历上的技术博客全部看完了,我还是很震惊的。但是他表示有些内容他并不认同。具体不认同什么,也没说什么。

所以后面我就不想太多的表达自己了。就是担心再被一些断章取义者,从一大段文字中找到一点细微的东西来作为武器攻击我。但是不写东西,没有释放自己的表达欲,也是很难受的一件事情,等于我放弃了触达那些真正气场合适人们的机会。我不能因为一些观念不和人的言论,放弃了寻找观念相和人们的机会。

所以现在,我重新开始写东西了,希望你喜欢。

(2)注意力是太重要的东西了。

前阵子出去放松了几天。有5天左右的时间远离“大城市”,切身感受到了小城市的节奏。在这里,太阳下山之后,就很少有灯光了,人们简单的餐饮过后就可以准备休息了。等太阳出来,就是新一天的惊艳的美景。这感觉太神奇了,可以慢悠悠的起床、睡觉,慢悠悠的走走,没有多少人是在步履匆匆的赶路,赚的钱不多,但足够生活的很好。

再次回到工作的城市,又开始快节奏,感觉每天的时间被各种事情天然的掏空,每天又有特别过载的信息要去阅读。所以越发的感觉注意力的珍贵。

在这个 ai 盛行的时代里,内容进一步爆炸,有好多东西几乎一眼 ai, 有的不得不读一下,有的可以滑走的就不看。能看到一些高质量的、接地气的文字,真的不容易。

所以管理好自己的注意力,好好的利用,注意力放在的地方,几乎就是我们未来会成为的样子。

(3)真正的成长,就是不再一味寻求被认可或喜爱

这一点也比较认同。作为小孩的时候得到大人的认同是很重要的,甚至成为一种用尽全身力气的生存之道。但是当自己成为大人,开始承担更大的责任,事情就不一样了。在现实社会中充满了冲突和误解,充满了对抗和背刺。每天要面对太多“离谱”的事情,还要去心平气和的处理,实在是不容易。若过载这种情况下,还用外部反馈来评判自己,那就是对自己的一种残忍。

任何时候,都要找到真正的榜样,认定正确的是事情然后坚持下去。不要摇摆,不要受外部蛊惑。要看清楚到底是水平不够的人在忽悠人,还是真正有价值的内容在低调的表述。我们要对低水平的冲突有足够的钝感,对高质量的内容有更高的敏感度。只有这样,我们才能在这个纷扰的世界活成更好的样子。

(4)你想活出怎样的人生?

之前看过这个电影,但是那时的自己有点看的似懂非懂。

或许到某个阶段,在看这个电影,或是思考这个问题,就有完全不同的感受了吧。

专业的网络延迟波动检测工具 irtt

irtt 专门测长期延迟稳定性和抖动,按固定间隔发包(如每 10ms 一个),统计 RTT、单向延迟、IPDV(抖动)和丢包。它比 ping 精确得多,很适合跑几小时甚至几天的稳定性测试。

相比于传统的 ICMP (Ping) 测试,IRTT 采用 UDP 能够更真实地模拟 VoIP、在线游戏等实时业务的流量,并能同时测量出双向丢包、单向延迟 (OWD) 以及抖动 (IPDV) 等深度指标。

irtt server
irtt client -i 10ms -d 1h -l 64 
<server_ip> -o result.json

在 alpine 下安装:

echo "@edgecommunity http://mirrors.ustc.edu.cn/alpine/edge/community" >> /etc/apk/repositories
apk update
apk add irtt@edgecommunity

其他系统按需安装。

也可以这样纯静态交叉编译后放到目标机器中使用:

$ git clone https://github.com/heistp/irtt.git
$ cd irtt
$ CGO_ENABLED=0 GOOS=linux GOARCH=arm64 go build -ldflags="-s -w -extldflags '-static'" -o irtt_linux_arm64 ./cmd/irtt

效果:

seq=1213 rtt=270µs rd=1.9s sd=-1.9s ipdv=71.5µs
seq=1214 rtt=254µs rd=1.9s sd=-1.9s ipdv=15.3µs
seq=1215 rtt=283µs rd=1.9s sd=-1.9s ipdv=28.3µs
interrupt
                        Min    Mean  Median     Max  Stddev
                        ---    ----  ------     ---  ------
                RTT   171µs   280µs   273µs  3.74ms   111µs
         send delay   -1.9s   -1.9s   -1.9s   -1.9s   105µs
      receive delay    1.9s    1.9s    1.9s    1.9s  18.9µs

      IPDV (jitter)   180ns  49.2µs    33µs  3.52ms   147µs
          send IPDV    63ns  41.1µs  26.4µs  3.45ms   143µs
       receive IPDV    30ns  18.2µs  13.8µs   158µs  17.7µs

     send call time  10.5µs  20.5µs           127µs  9.05µs
        timer error    76ns   258µs           925µs   159µs
  server proc. time  2.95µs  6.57µs          53.8µs  2.55µs

                duration: 12.2s (wait 0s)
   packets sent/received: 1217/1216 (0.08% loss)
 server packets received: 1216/1217 (0.08%/0.00% loss up/down)
     bytes sent/received: 77888/77824
       send/receive rate: 51.2 Kbps / 51.2 Kbps
             timer stats: 2/1219 (0.16%) missed, 2.58% error

LXC 热载入设备文件

下面以向运行中的 LXC 容器注入 /dev/vhost-net 为例讲解。

有两种思路:临时注入(容器重启后失效)和永久配置(写入配置)。有时无法重启 lxc 容器,希望配置生效,就可以用临时注入热载入,在写入配置,这样现在就可以用,下次重启后载入配置就不用热载入了。下面介绍方法:

临时注入

(容器运行中,立即生效)

步骤 1:在宿主机上确认设备号

ls -l /dev/vhost-net
# crw-rw-rw- 1 root kvm 10, 238 ... /dev/vhost-net

主设备号通常是 10,次设备号常见为 238(以你机器输出为准)。

如果没有该设备,先加载模块:

modprobe vhost_net

步骤 2:在容器的 devices cgroup 中放行该设备

cgroup v1:

lxc-cgroup -n <容器名> devices.allow "c 10:238 rwm"

cgroup v2(现代发行版默认)没有 devices.allow 文件,设备控制基于 eBPF,lxc-cgroup 一般无法这样动态修改。此时建议改用下面的”永久配置 + 重启”。

步骤 3:在容器内创建设备节点

lxc-attach -n <容器名> -- mknod -m 666 /dev/vhost-net c 10 238

或直接去容器里执行后面的命令即可。

注意:如果是非特权容器,容器内 mknod 通常会被拒绝(用户命名空间中没有 CAP_MKNOD),此时需要用 bind mount 方式或永久配置。

替代:直接 bind mount 设备文件(不需要 mknod)

# 找到容器的 rootfs 路径后,在宿主机上创建目标文件并 bind mount
touch /var/lib/lxc/<容器名>/rootfs/dev/vhost-net
mount --bind /dev/vhost-net /var/lib/lxc/<容器名>/rootfs/dev/vhost-net

(还需要 cgroup 放行,否则容器里访问会得到 Operation not permitted。)

永久配置

编辑 /var/lib/lxc/<容器名>/config(或 ~/.local/share/lxc/...):

# cgroup v1
lxc.cgroup.devices.allow = c 10:238 rwm

# cgroup v2
lxc.cgroup2.devices.allow = c 10:238 rwm

# 自动挂载设备节点
lxc.mount.entry = /dev/vhost-net dev/vhost-net none bind,create=file 0 0

然后重启容器。

解决宝塔安装 PG 失败的问题

在宝塔面板安装 PostgreSQL 时遇到 pgsql_install.sh: 83: Syntax error: Bad fd number 错误,排查发现是我使用的系统 (Debian13) 默认的 /bin/sh 链接到了 dash(常见于 Ubuntu/Debian 系统),而安装脚本中使用了部分 dash 不支持的语法或重定向符号。

错误日志类似下面这样:

pgsql_install.sh: 83: Syntax error: Bad fd number

检索了一下,官方论坛在很早就出现了这个问题,但至今没有很好的解决,因此将解决方案在这里记录一下。

解决方法

可以通过将系统的默认 /bin/sh 临时或永久更改指向 bash 来解决该问题。 

步骤 1:检查当前的 sh 指向 

在终端执行以下命令:

ls -l /bin/sh

如果输出显示指向 dash(例如 /bin/sh -> dash),说明确实是这个原因。 

步骤 2:将 sh 更改为 bash 

执行下面命令将 /bin/sh 重新定向到 /bin/bash:

sudo mv /bin/sh /bin/sh.bk
sudo ln -s /bin/bash /bin/sh

步骤 3:重新在宝塔面板中安装 

更改完成后,回到宝塔面板,重新卸载并再次尝试安装 PostgreSQL 插件及数据库。 

在 DSH 手动启用 OpenCode Go DeepSeek v4.1 新模型

最近在使用 DeepSeek Harness 时,对接 DeepSeek 官方模型,奈何消耗过高,一会儿就几块钱出去了,于是打算对接 opencode go 订阅,但是发现对接时 dsh 一方面没有 dsv4.1 模型,一方面是对接直接报错。

考虑到这个问题应该会很快被解决,但是由于需要立刻用上,就简单整理一下解决方案,出现同样的问题的朋友可以参考一下。

背景

DSH 不维护模型清单,opencode-go 的模型来自上游 @earendil-works/pi-ai 的静态目录。该目录滞后于 OpenCode 实际提供的模型,需要在 ~/.dsh/settings.yaml 手工补充。

但是直接加也不行,会有几个约束:

约束

  1. 不能往内置 opencode-go 路由里直接加模型。 单个 model 条目只接受 name/contextWindow/maxTokens/input/reasoningEfforts/compat,api 和 baseURL 是路由级字段。而 opencode-go 是混合协议路由(27 个模型分属 3 种 wire protocol),新模型无处继承 api,直接加会报:

    model "xxx" needs an api; the installed catalog does not describe it

    在路由级写 api 又会把全部 27 个模型强制成同一协议。解法是新开一条单协议路由。

  2. OpenCode Go 自 2026-09-05 起要求 x-opencode-session 请求头,pi-ai 不发送该头,否则报 400 MissingSessionID。见 discussions#5495。

配置方法

编辑 ~/.dsh/settings.yaml:

注,这里面的随机串记得替换

llm-pi-ai:
  providers:
    opencode-go:
      apiKeyEnv: OPENCODE_GO_API_KEY
    opencode-go-v41:
      displayName: OpenCode Go (V4.1)
      apiKeyEnv: OPENCODE_GO_API_KEY
      api: openai-completions
      baseURL: https://opencode.ai/zen/go/v1
      headers:
        x-opencode-session: dsh-local-<随机串>
      models:
        - id: deepseek-v4.1-flash
          name: DeepSeek V4.1 Flash
          contextWindow: 1000000
          maxTokens: 384000
          input: [ text, image ]
          reasoningEfforts: { low: low, high: high, max: max }
          compat:
            supportsStore: false
            supportsDeveloperRole: false
            maxTokensField: max_tokens
            requiresReasoningContentOnAssistantMessages: true
            thinkingFormat: deepseek

agent-default-model:
  provider: opencode-go-v41
  model: deepseek-v4.1-flash
  reasoningEffort: high

注意:

  • 路由必须放在 providers 字典下,键名即路由名,不要写错层级了。
  • 两条路由共用同一个 apiKeyEnv,无需重复配置凭据。
  • 改动下次请求生效,不必重启。

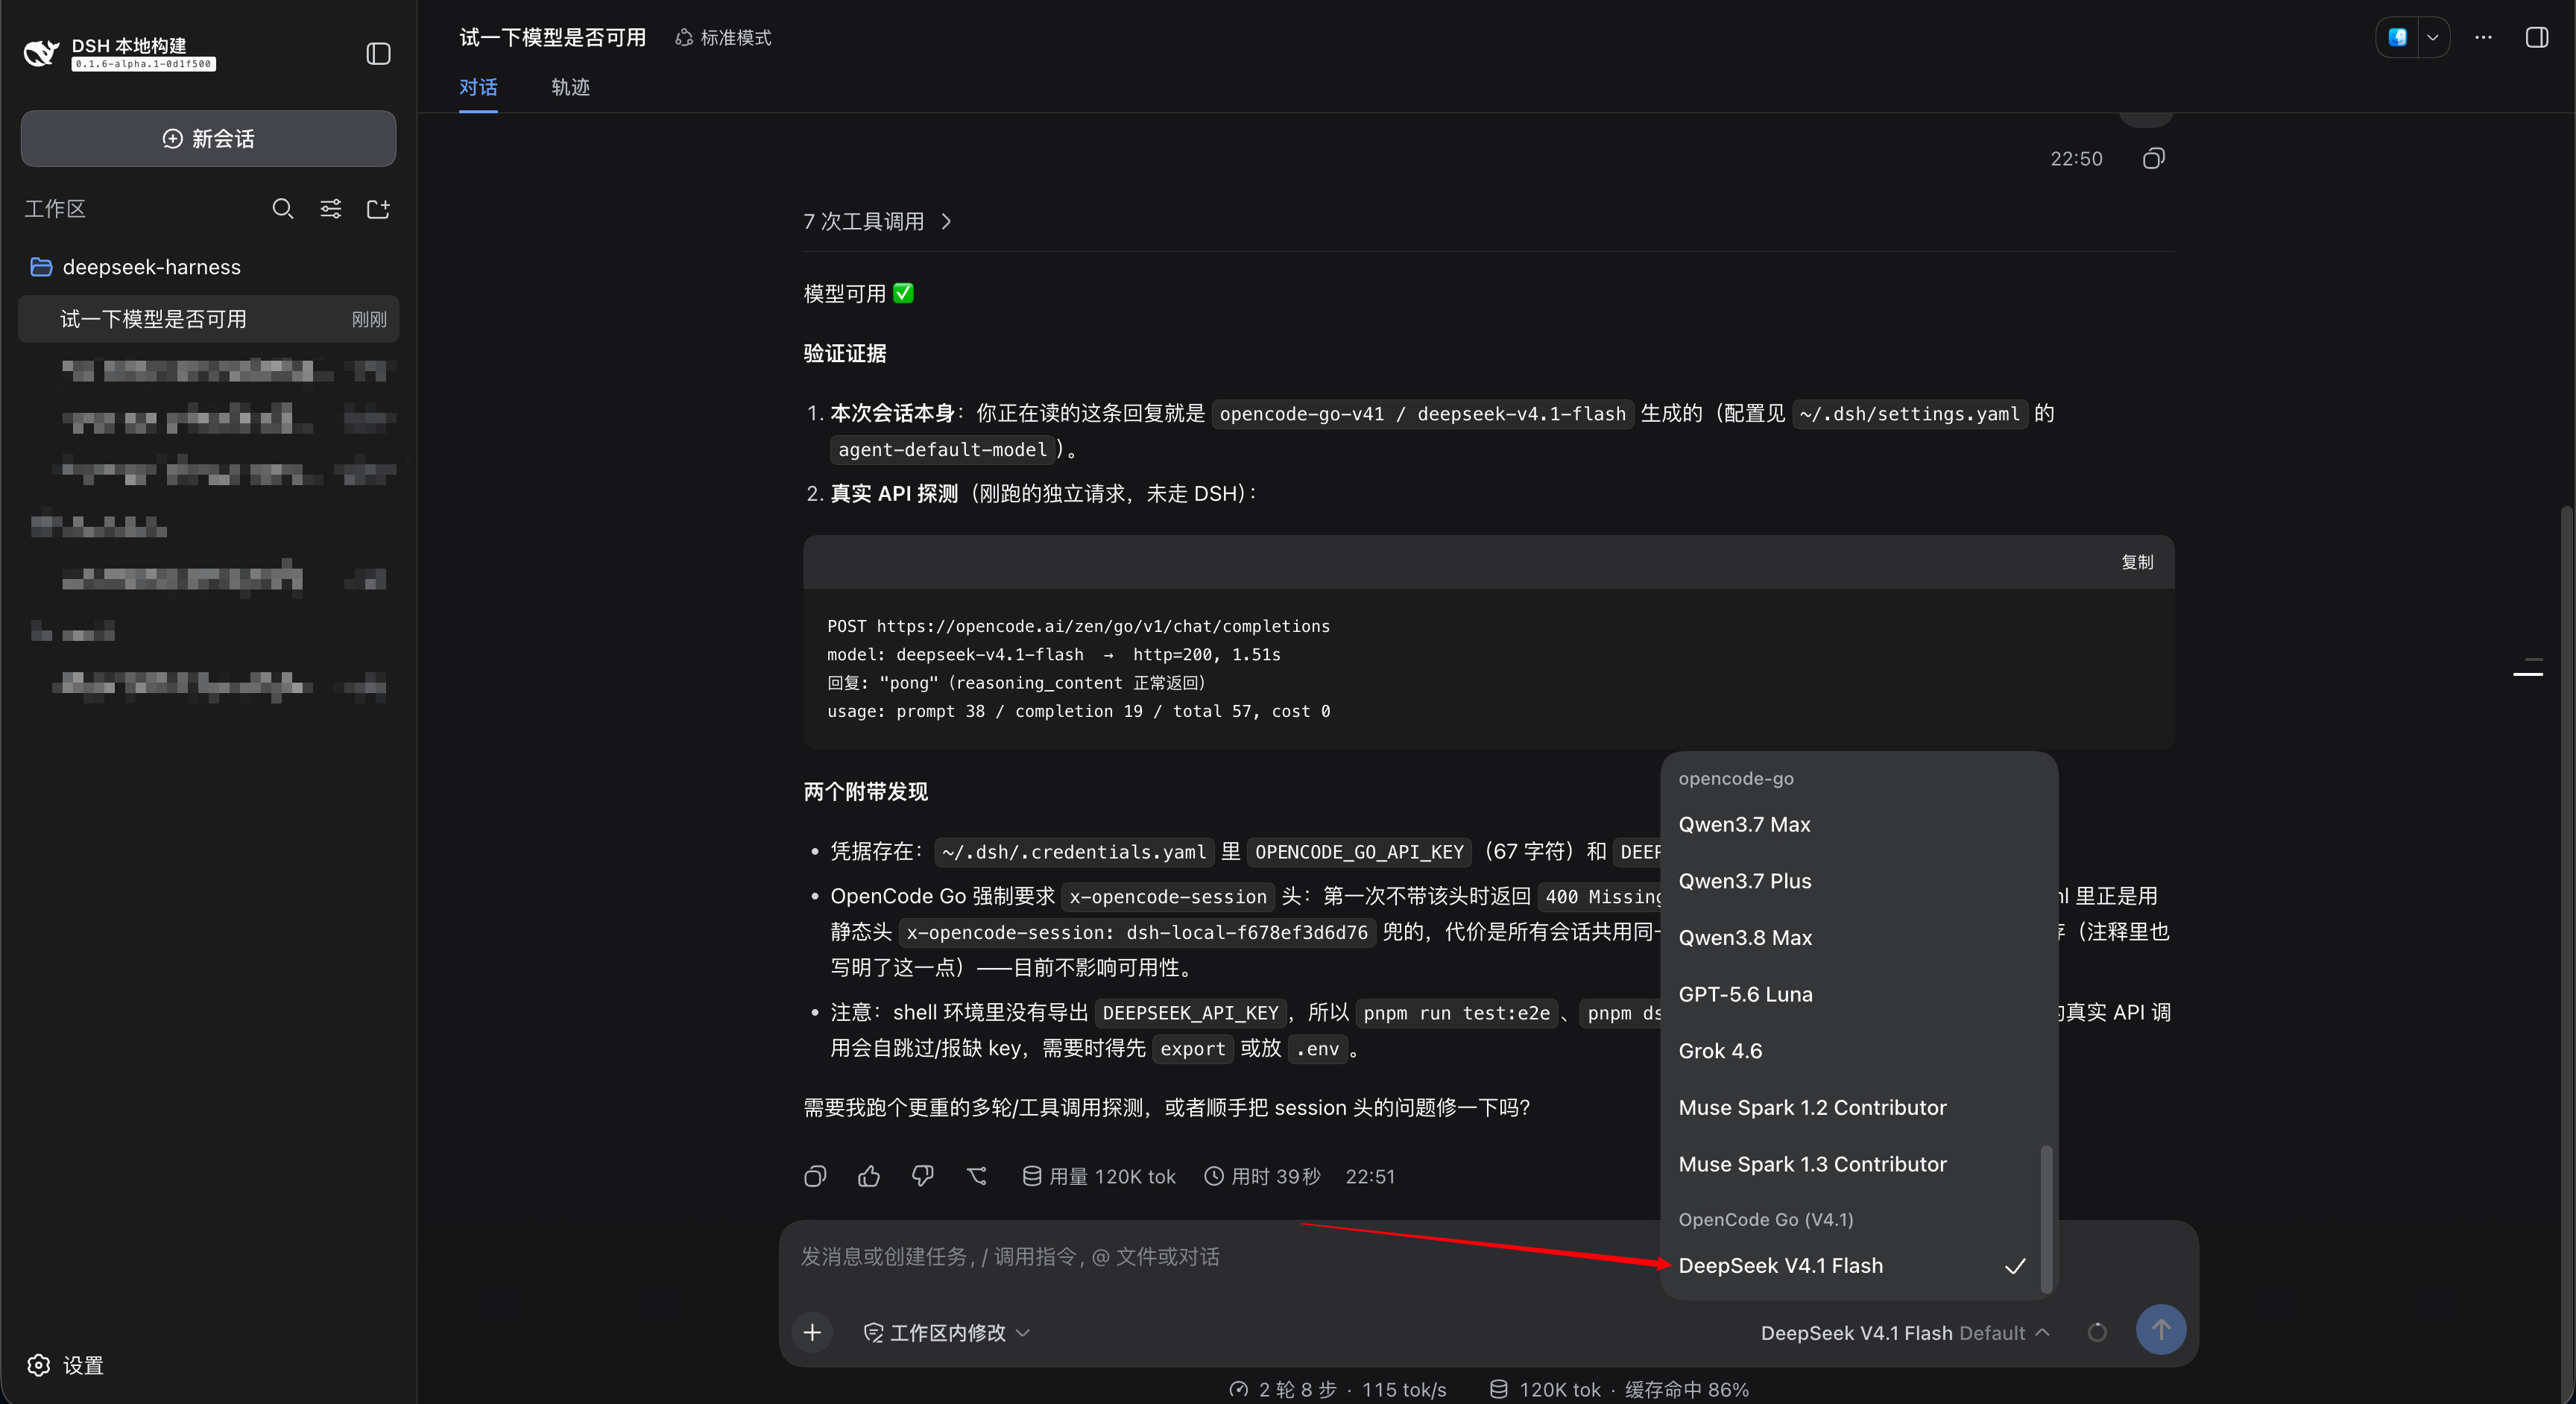
设定后在GUI 模型选择器中会出现 OpenCode Go (V4.1) 分组。

最后就可以正常调用了:

DeepSeek Harness with opencode go ds v4.1

关于 x-opencode-session 的说明

上面用的是静态值,所有会话共用一个 id。能解除 400,但服务端会认为所有对话是同一段,prompt 缓存会失效(该模型缓存读取 $0.003 vs 输入 $0.15,长对话差异明显)。

更好的替代:社区插件 dsh-opencode-session 复用 DSH 会话 id,每会话唯一且跨轮次稳定。

dsh plugin --profile web add dsh-opencode-session

装后删掉配置里的 headers 段。需完全重启 dsh。该插件会 patch 全局 fetch,安装前建议先审查源码。

官方修复进展见 discussions#5495;届时两种 workaround 都可退役。

解决 Linux Wayland 环境下 Joplin 使用 fcitx5 中文输入漏字问题

在 Linux + Wayland 环境下使用 Joplin 时,如果配合 fcitx5 输入中文,可能会遇到输入漏字的问题。

下面这份配置可作为参考:

➜  Downloads cat /usr/share/applications/joplin-desktop.desktop
[Desktop Entry]
Name=Joplin
Comment=Joplin for Desktop
-Exec=/usr/bin/joplin-desktop --gtk-version=3 --ozone-platform=x11
+Exec=/usr/bin/joplin-desktop --gtk-version=3 --ozone-platform-hint=auto --enable-wayland-ime
Terminal=false
Icon=joplin-desktop
StartupWMClass=@joplin/app-desktop
Type=Application
Categories=Office;
MimeType=x-scheme-handler/joplin;
SingleMainWindow=true

使用 --ozone-platform=x11 可以解决 Joplin 全局菜单不显示的问题,但中文输入时可能会出现漏字。

改用 --ozone-platform-hint=auto --enable-wayland-ime 后,可以解决 fcitx5 中文输入漏字的问题;不过相应地,Joplin 全局菜单可能又无法正常显示。

实测二者不可两全,暂无找到很好的方法。建议先采用第一行配置,显示出来菜单做好配置后,改用第二行配置,确保后期中文输入体现。

输入漏字真的很恼火,如有两全解决方案欢迎讨论。

Refs